Generative KI hat unsere Welt verändert, indem sie Inhalte erstellen kann, die die menschliche Intelligenz nachahmen. Stellen Sie sich vor, die Technologie produziert nach Belieben und ohne Anstrengung Artikel, Kunst oder Musik. Das ist einfach unglaublich.
Aber hier ist die Wendung. Ist der Einsatz dieser Technologie immer legal? Einige sagen vielleicht „Ja“, während andere ethische Bedenken äußern.
Die Datennutzung ist zentral für diese Debatte. Generative KI benötigt riesige Datenmengen, die dem Modell helfen, zu lernen und neue Inhalte zu generieren. Doch woher stammen diese Daten? Deshalb ist es entscheidend, sie auf ethisch einwandfreie Weise zu beschaffen.
- Digitale Künstler auf Plattformen wie ArtStation protestieren. Ihre Kunstwerke werden als Trainingsdaten für KI-Modelle verwendet und es fallen Namen wie Midjourney und Stable Diffusion.
- Microsoft, GitHub und OpenAI sollen angeblich die Werke von Künstlern und den Code von Programmierern abgekratzt haben, um ihre KI-Modelle zu trainieren.
- Getty Images, ein Gigant in Großbritannien, forderte Stability AI heraus über die Verwendung ihrer Stockbilder.
- Die jüngsten Nachrichten verdeutlichen weitere Kontroversen. Die Macher von Game of Thrones gehören zu den 17 Parteien, die dies getan haben eine Klage. Sie behaupten, dass OpenAI systematischen Diebstahl im großen Stil begangen habe.
Werfen wir also einen genaueren Blick auf diese Kontroverse und diskutieren wir, wie KI-Modelle Daten auf der ganzen Welt mithilfe des Gesetzes beschaffen, selbst wenn wir hören: „Einwilligung ist der Schlüssel.“
Das Gesetz umgehen
Das wirft eine große Frage auf. Die meisten von KI-Modellen verwendeten Internetdaten verfügen nicht über Erstellerberechtigungen. Diese Ersteller werden weder genannt noch bezahlt. Ist das fair?
In den USA gibt es das Fair-Use-Gesetz . Es erlaubt die Nutzung urheberrechtlich geschützter Werke auf neue Weise, beispielsweise für Kritik oder Parodien. Viele KI-Entwickler berufen sich auf dieses Gesetz, verwenden die Inhalte aber als Trainingsdaten, anstatt Datenlizenzen zu erwerben. Gilt das Fair-Use-Gesetz auch für KI-Trainingsdaten?
 Schauen wir nach Europa. In der EU gibt es ein strenges Datenschutzgesetz namens Datenschutz-Grundverordnung (DSGVO). Es geht um die Einwilligung des Nutzers zur Datennutzung. Unternehmen können Daten nicht einfach übernehmen, da sie die Zustimmung des Benutzers benötigen. Verstößt also ein KI-Modell gegen dieses Gesetz, indem es Ihre Fotos oder Kunstwerke verwendet? Wenn ja, was wird die EU tun?
Diese Fragen stehen auf dem Spiel und werden die Art und Weise prägen, wie wir KI in Zukunft nutzen.
Akzeptieren oder loslassen
Ist es zu spät zum Handeln? In den USA, Großbritannien und der EU dauern die juristischen Debatten auch 2023 noch an. Doch große Sprachmodelle und Bildtransformationsprogramme verdeutlichen das Potenzial des Trainings mit riesigen Datenmengen . Manche meinen, der Geist sei aus der Flasche. Künstliche Intelligenz wird sich mit Modellen, die als „ Grundlagenmodelle “ bezeichnet werden, voraussichtlich weiterentwickeln.
Ein wichtiger Punkt : Manche KI-Experten glauben, dass gelockerte Urheberrechtsgesetze den Fortschritt fördern. Eine Studie mit dem Titel „ Fair Learning “ legt nahe, dass die faire Nutzung von Online-Daten unerlässlich ist. Ohne sie könnte die KI-Entwicklung stagnieren.
Geld fließt in die generative KI und Risikokapitalgeber sehen ihr enormes Potenzial. Das Versprechen, den Technologieeinsatz neu zu gestalten, stößt auf Interesse, da die Zukunft der KI eindeutig rosig ist.
Mit Shaip einen Unterschied machen
Generative KI sorgt für Aufsehen, und ihre Zukunft ist aufgrund rechtlicher Debatten, beispielsweise in den USA und der EU, ungewiss. Klar ist jedoch, dass diese Technologie gekommen ist, um zu bleiben. Community-basierte oder Open-Source-Datensätze könnten sie in naher Zukunft antreiben. Die EU stellt mit der DSGVO und dem kommenden KI-Gesetz zusätzliche Herausforderungen dar.
Wie kann Ihr Unternehmen von dieser Technologie profitieren und dabei ethisch und global agieren? Schauen Sie sich Shaip an , denn wir haben die passenden Lösungen.
Seit unserer Gründung haben wir uns für maßgeschneiderte, hochwertige Datensätze für KI-Projekte entschieden. Wir bieten mehr als nur saubere Daten, da wir das Rauschen beseitigen, das häufig in Open-Source-Sets auftritt. Unsere Datensätze enthalten detaillierte demografische Details, um sicherzustellen, dass es keine Verzerrungen gibt.
Wir sind der Grundüberzeugung: KI sollte gerecht und fair sein.
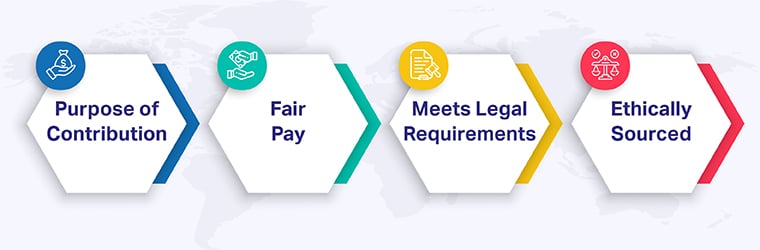
Unsere Priorität sind die Menschen hinter den Daten . Wir stellen sicher, dass jeder Beitragende seine informierte Einwilligung gibt. Wir sehen Daten als Kern der KI und Menschen als Kern der Daten. Sie sollen den Zweck ihres Beitrags kennen und eine angemessene Vergütung erhalten.
Wir verfolgen einen zweifachen Ansatz. Es erfüllt alle rechtlichen Anforderungen und respektiert und wertschätzt gleichzeitig die Datenlieferanten. Viele derjenigen, die KI-Unternehmen verklagen, wollen Anerkennung und Fairness, und wir stellen sicher, dass sie ihren gerechten Anteil bekommen.
Während sich die Welt mit der Zukunft der KI auseinandersetzt, bietet Shaip einen Weg nach vorne. Wenn Sie bereit sind, KI für Ihr Unternehmen zu nutzen, entscheiden Sie sich für ethische, weltweit konforme Daten. Genau das bietet Shaip.
Nehmen Sie Kontakt mit Shaip auf . Lassen Sie uns Ihr Unternehmen auf dem richtigen Weg ins KI-Zeitalter führen.