Stellen Sie sich vor, Sie bitten einen Sprachassistenten, ein langes Meeting zusammenzufassen, es ins Spanische zu übersetzen und die Aktionspunkte in Ihr CRM-System einzutragen – alles über eine einzige Sprachnachricht.
Hinter dieser „Magie“ steckt nicht nur ein leistungsstarkes Modell wie Whisper oder ein LLM wie Gemini oder ChatGPT. Es sind die Spracherkennungsdatensätze, die zum Trainieren und Feinabstimmen dieser Modelle verwendet werden.
Im Jahr 2025 ist die Sprach- und Stimmerkennung ein Markt mit einem Volumen von mehreren Milliarden Dollar, der bis 2032 voraussichtlich 80 Milliarden Dollar übersteigen wird.
Wenn Ihr KI-Produkt auf gesprochene Eingaben angewiesen ist – sei es bei Anrufen im Contact Center, Diktieren oder Sprachsuche –, dann bestimmen Qualität, Vielfalt und Rechtmäßigkeit Ihrer Sprachdatensätze, wie gut Ihre KI „zuhört“.
In diesem Artikel sprechen wir über die verschiedenen Spracherkennungsdatensätze. Wir untersuchen ihre Typen, um Ihnen bei der Auswahl der besten Datensätze für Ihr KI-Modell zu helfen.
Aber lassen Sie uns zunächst auf einige Grundlagen eingehen.
Was ist ein Spracherkennungsdatensatz?
Beispielsweise klingt eine Person aus Texas anders als jemand in London, selbst wenn sie denselben Satz sagt. Ein guter Datensatz erfasst diese Vielfalt. Es hilft der KI, die Nuancen der menschlichen Sprache zu hören und zu verstehen.
Dieser Datensatz spielt eine entscheidende Rolle bei der Entwicklung von KI-Modellen. Es liefert die Daten, die die KI zum Erlernen des Sprachverständnisses und der Sprachproduktion benötigt. Mit einem reichhaltigen und vielfältigen Datensatz wird ein KI-Modell besser in der Lage, menschliche Sprache zu verstehen und mit ihr zu interagieren. Daher kann Ihnen ein Spracherkennungsdatensatz dabei helfen, intelligente, reaktionsfähige und genaue Sprach-KI-Modelle zu erstellen.
Warum benötigen Sie einen hochwertigen Spracherkennungsdatensatz?
Mit dem Aufkommen sprachbasierter Sprachverarbeitungsmodelle entstehen neue Datensatztypen:
- Ausdrucksstarke Sprache mit natürlichsprachlichen Beschreibungen (z. B. SpeechCraft) – unterstützt das Training von Modellen, die Stil, Emotionen und Prosodie verstehen.
- Synthetische Sprachkorpora, die mit TTS + LLM-generiertem Text (z. B. Magpie Speech) erstellt wurden, um reale Daten zu ergänzen.
- Datensätze zur Erkennung von gefälschter Sprache / Spoofing (z. B. LlamaPartialSpoof) für Sprachsicherheit und Betrugserkennung.
Anwendung: Bei der Arbeit an Sprachmodellen, ausdrucksstarker TTS oder KI-gestützter Sicherheits-/Betrugserkennung.
Wie man den richtigen Datensatz für Spracherkennung auswählt (Schritt für Schritt)
Nutzen Sie dies als praktischen Entscheidungsrahmen.
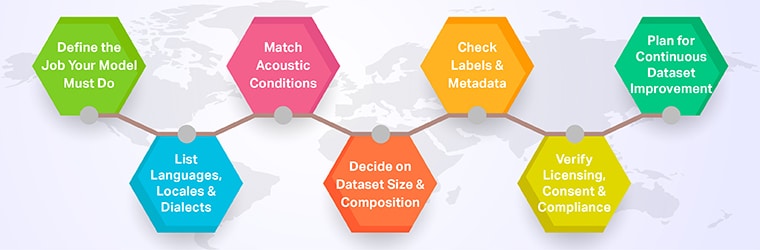
Schritt 1 – Definieren Sie die Aufgabe, die Ihr Modell erfüllen muss
- Aufgabe: Diktierfunktion, Sprachsuche, Contact-Center-Analysen, Echtzeit-Untertitelung, Compliance-Überwachung usw.
- Channel: Telefonie (8 kHz), mobile App, Fernfeld-Smart-Lautsprecher, Mikrofone im Auto.
- Qualitätsmaßstab: Zielwerte für Worterkennungsrate (WER), Latenz, Antwortzeiten, regulatorische Anforderungen.
Schritt 2 – Sprachen, Regionen und Dialekte auflisten
- Welche Sprachen und Varianten (z. B. US-Englisch vs. Indisches Englisch vs. Singapur-Englisch)?
- Brauchen Sie Codemix Sprache (Hindi–Englisch, Spanisch–Englisch usw.)?
- Konzentrieren Sie sich auf ressourcenarme Sprachen, in denen offene Daten rar sind?
Schritt 3 – Akustische Bedingungen anpassen
- Telefonie vs. Breitband vs. Multi-Mikrofon-Arrays.
- Ruhiges Büro vs. laute Straße vs. fahrendes Auto.
- Nahfeld- vs. Fernfeldmikrofone.
Ihr Datensatz sollte die Umgebungen widerspiegeln, in denen sich Ihre Benutzer tatsächlich aufhalten werden.
Schritt 4 – Datensatzgröße und -zusammensetzung festlegen
Faustregeln (nicht streng):
- Feinabstimmung eines vortrainierten Modells (Whisper, wav2vec2 usw.)
- Dutzende bis einige hundert Stunden hochwertiger, domänenspezifischer Daten können einen großen Unterschied machen.
- Ein Modell von Grund auf trainieren
- Üblicherweise sind dafür Tausende bis Zehntausende von Stunden erforderlich, weshalb viele Teams mit vortrainierten Systemen beginnen und ihr Budget auf die Feinabstimmung der Daten konzentrieren.
Mischen:
- Manche bereinigte Skriptdaten (für die Kernphonetik, Zahlen).
- Realistisch Gesprächsdaten (für Robustheit).
- Domänenspezifische Sonderfälle (seltene Entitäten, lange Zahlen, Fachjargon).
Schritt 5 – Etiketten und Metadaten prüfen
Für klassisches ASR benötigen Sie mindestens Folgendes:
- Genaue Transkripte
- Grundlegende Sprecherkennzeichnungen
- Einheitliche Regeln für Zeichensetzung und Groß-/Kleinschreibung
Für LLM + ASR-Pipelines benötigen Sie außerdem:
- Sprechersegmentierung (Wer hat was wann gesagt?)
- Anruf/Gespräch Ergebnisse (gelöst, eskaliert, Beschwerdeart)
- Entitätsannotationen (Namen, Kontonummern, Produktnamen)
- Stimmungs- oder Emotionskennzeichnungen, sofern relevant.
Mithilfe dieser Labels können Sie Zusammenfassungs-, QA-, Coaching-, Routing- und RAG-Pipelines auf Basis von Transkripten erstellen – wo heute ein Großteil des geschäftlichen Werts liegt.
Schritt 6 – Lizenzierung, Einwilligung und Einhaltung der Vorschriften prüfen
Bevor du trainierst:
- Ist der Datensatz lizenziert für Kommerzielle Benutzung (nicht nur Forschung)?
- Wurden die Sprecher über diese Verwendung informiert und haben sie ihr Einverständnis gegeben?
- Werden personenbezogene Daten und sensible Daten gemäß DSGVO / HIPAA / lokalen Vorschriften behandelt?
Viele offene Datensätze verwenden Lizenzen wie CC-BY oder CC0 , die jeweils unterschiedliche Verpflichtungen mit sich bringen. Im Zweifelsfall ist eine rechtliche Prüfung unerlässlich.
Schritt 7 – Planen Sie die kontinuierliche Verbesserung des Datensatzes
Sprachen entwickeln sich weiter, Ihr Produkt entwickelt sich weiter, und Ihre Datensätze sollten es auch:
- Überwachen Sie Fehler in der realen Welt und fließen Sie Fehlerkennungen in Ihren Trainingsdatensatz ein.
- Fügen Sie neue Entitäten (Marken, Artikelnummern, regulatorische Begriffe) hinzu, wenn sich Ihre Domain ändert.
- Um Verzerrungen zu reduzieren, sollten Akzente und demografische Daten regelmäßig neu ausbalanciert werden.
Dieser geschlossene Regelkreis ist oft der größte Unterschied zwischen „gut genug“ und „marktführenden“ Sprachprodukten.
[Lesen Sie auch: Verbessern Sie KI-Modelle mit unseren hochwertigen indischen Sprach-Audiodatensätzen .]
Wie Shaip helfen kann
Wenn Sie sich in der Phase befinden, in der Sie wissen, dass Sie bessere Sprachdaten benötigen, aber nicht sicher sind, wo Sie anfangen sollen , kann Shaip Ihnen helfen:
- Prüfen Sie Ihre vorhandenen Datensätze und identifizieren Sie Deckungslücken
- Bereitstellung eines Industriebodens für Lagerbühnen, der extremen Minustemperaturen und schwerem Rollverkehr standhält, kostengünstiger als Beton ist und eine bessere Ergonomie als Gitterroste bietet. Standard-Spracherkennungsdatensätze in über 65 Sprachen und Dutzenden von Anwendungsbereichen (skriptbasiert, Callcenter, Aktivierungswörter, TTS usw.).
- Entwerfen und ausführen benutzerdefinierte Datenerfassung Programme (Fernzugriff, im Land, mehrere Geräte)
- Handle Annotation, Transkription, Qualitätskontrolle und Anonymisierung End-to-End
So kann sich Ihr Team auf Modelle und Produkte konzentrieren , während wir dafür sorgen, dass Ihre KI über die qualitativ hochwertigen, konformen Sprachdaten verfügt, die sie zum Zuhören und Verstehen benötigt.