
Keine Anwendungsfälle gefunden.

Trainieren Sie maschinelle Lernalgorithmen, um in Bildern und Videos vorhandene Bilder oder Objekte zu klassifizieren.

Daten zum Trainieren virtueller/digitaler Assistenten und Chatbots, um auf menschliche Sprache in einer Vielzahl von Sprachen, Umgebungen und Kontexten zu reagieren.

Identifizieren und transkribieren Sie Text in Audio oder Video schnell und genau digital durch unseren Transkriptionsspezialisten.

Segmentierung von Objekten in Bildern in die relevanten Kategorien. Segmentierung ist in einfachen Worten das Zuweisen von Labels zu Pixeln.

Kuratieren Sie Bilddatensätze mit Variationen von Geschlecht, innen und außen, Lichtverhältnissen, Aufnahmewinkel, Altersgruppe usw., um ein Gesichtserkennungsmodell für den Einzelhandel zu erstellen.

Bilder und ihre Beschreibungen sollten Hand in Hand gehen. Während Bilder beim Kunden Interesse wecken sollen, sollen Beschreibungen dieses aufrechterhalten und zum Kauf animieren. Lassen Sie Ihre Machine-Learning-Systeme die Bild- und Produktgenauigkeit automatisch überprüfen und optimieren.

Klassifizieren Sie Dokumente nach ihrem Inhalt (z. B. Technologie, Sport, Filme usw.)

Kategorisieren Sie Laute oder Äußerungen, um Sprache/Audio basierend auf Sprache, Dialekt, Semantik, Lexika usw. zu klassifizieren.

Kommentieren Sie Versicherungsunternehmen mithilfe von zertifizierten Domänenexperten mit hoher Genauigkeit aus Dokumenten.

Von der Handschrift von Ärzten bis hin zu ärztlichen Rezepten transformieren unsere Transkriptionsspezialisten medizinische Daten wie Archivdokumente, Verträge, Krankenakten digital mit garantierter TAT, Genauigkeit und Einsparungen.

Semantische Segmentierung von Bildern/Videos Frame für Frame, die Objekte wie Fußgänger, Fahrzeuge – (Autos, Fahrräder, Busse), Straßen, Laternenmasten zum Aufbau hochwertiger Trainingsdaten für KI-basierte autonome Fahrzeugsysteme umfasst.

Aktivieren Sie ein hochpräzises Fahrerüberwachungssystem, indem Sie Gesichtsmerkmale wie Augen, Kopf, Mund usw. mit hoher Genauigkeit und relevanten Metadaten für die Blinzelerkennung und Blickschätzung kommentieren.

Kommentieren Sie Fußgänger in verschiedenen Bildern mit 2D-Bounding-Boxen, um hochwertige Trainingsdaten für die Fußgängerverfolgung zu erstellen.

Shaip unterstützt Unternehmen bei der Erfassung, Aufbereitung, Anonymisierung, Strukturierung, Annotation und Lizenzierung genehmigter interner Geschäftsdaten – einschließlich Dokumente, E-Mails, Datensätze und damit verbundene Arbeitsabläufe – für KI-Training, Evaluierung, Dokumentenanalyse, Wissensextraktion und aufgabenspezifische Modellanpassung.

Linguistische Qualitätssicherung (LQA) ist der Prozess der Überprüfung und Bewertung übersetzter oder lokalisierter Inhalte, um sicherzustellen, dass sie den sprachlichen Standards hinsichtlich Genauigkeit, Grammatik, Stil und kultureller Relevanz entsprechen. Sie trägt dazu bei, eine qualitativ hochwertige Kommunikation über verschiedene Sprachen hinweg sicherzustellen.

Stärken Sie künstliche Intelligenz mit datengesteuerter Inhaltsmoderation und genießen Sie das verbesserte Vertrauen und den guten Ruf der Marke.

Die Konsumdynamik hat sich in den letzten Jahren drastisch gewandelt. Die Menschen wollen personalisierte Einkaufserlebnisse. Dies können Sie Ihren Kunden nur durch leistungsstarke Empfehlungsmaschinen vermitteln.
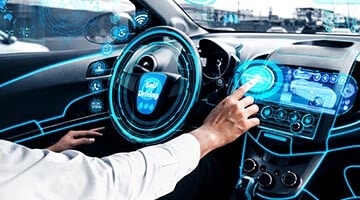
Trainieren Sie maschinelle Lernalgorithmen für selbstfahrende Autos mithilfe der Bild- und Videosegmentierung. Kategorisieren Sie Person, Fahrzeug, Verkehrszeichen, Fahrspuren usw.

Analysieren, verschreiben und prognostizieren Sie Ergebnisse besser mit unseren soliden Finanzdaten-Annotationsdiensten
Die Konsumdynamik hat sich in den letzten Jahren drastisch gewandelt. Die Menschen wollen personalisierte Einkaufserlebnisse. Dies können Sie Ihren Kunden nur durch leistungsstarke Empfehlungsmaschinen vermitteln.
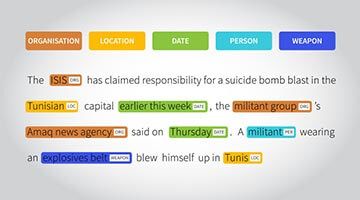
Trainieren Sie maschinelle Lernalgorithmen, um die in einem Textdokument präsentierten benannten Entitäten zu identifizieren und zu klassifizieren, indem Sie sie in vordefinierte Kategorien einordnen (z. B. Person, Organisation, Ort usw.).

Trainieren Sie Algorithmen für maschinelles Lernen, um KI-Modelle im Gesundheitswesen zu entwickeln, indem Sie Text in Entitätstypen, Modifikatoren und Beziehungen annotieren.

Nutzen Sie die Leistungsfähigkeit der generativen KI, um komplexe Daten in umsetzbare Informationen umzuwandeln.

Erleben Sie beispiellose Klarheit und Flüssigkeit bei jeder Interaktion mit unseren fachmännisch kuratierten TTS-Datensätzen, die auf globale Sprachen zugeschnitten sind.

Analysieren Sie menschliche Emotionen und Gefühle, indem Sie Nuancen in Kundenbewertungen, Finanznachrichten, sozialen Medien usw. interpretieren.

Erkennen Sie automatisch ein oder mehrere menschliche Gesichter basierend auf Gesichtsmerkmalen in einem Bild oder Video. Durchsuchen Sie eine vorhandene Datenbank mit menschlichen Gesichtern, um sie zu vergleichen und abzugleichen, um eine intelligente Gesichtserkennungsplattform aufzubauen.

Erstellen Sie Sprach-Apps, die immer zuhören, mit benutzerdefinierten Wake-Word-Trainingsdaten.

Enthüllen Sie schon heute die Zukunft mit präzisen Trainingsdaten für AR- und VR-Technologien.

Annotation von Satellitenbildern und UAV-Fotografie, Vorbereiten von Datensätzen für die Geoverarbeitung und Annotieren von 3D-Punktwolken für Geo.AI.

Mit Technologien, Algorithmen und Frameworks der nächsten Generation kann die KI den Prozess der Identifizierung und Erkennung beschädigter Teile, die Bewertung des Schadensausmaßes, die Vorhersage der Art der erforderlichen Reparatur und die Schätzung der Gesamtkosten verstehen.

Stärken Sie künstliche Intelligenz mit datengesteuerter Inhaltsmoderation und genießen Sie das verbesserte Vertrauen und den guten Ruf der Marke.

Immer einen Schritt voraus mit präzisen Ergebnissen durch hochwertige Trainingsdaten für Technologiemodule
Trainieren Sie Algorithmen für maschinelles Lernen, um KI-Modelle im Gesundheitswesen zu entwickeln, indem Sie Text in Entitätstypen, Modifikatoren und Beziehungen annotieren.

Erkennen Sie automatisch ein oder mehrere menschliche Gesichter basierend auf Gesichtsmerkmalen in einem Bild oder Video. Durchsuchen Sie eine vorhandene Datenbank mit menschlichen Gesichtern, um sie zu vergleichen und abzugleichen, um eine intelligente Gesichtserkennungsplattform aufzubauen.
Menschliche Intelligenz zur Umwandlung von Natural Language Processing (NLP) in hochwertige Trainingsdaten für maschinelles Lernen mit Text- und Audioannotation.

Stärken Sie künstliche Intelligenz mit datengesteuerter Inhaltsmoderation und genießen Sie das verbesserte Vertrauen und den guten Ruf der Marke.

LLMs sind Computerprogramme, die Texte analysieren und schnelle und effiziente Lösungen für verschiedene Aufgaben bereitstellen.

Indische Sprachdatensätze unterstützen NLP-Aufgaben wie Übersetzung, Spracherkennung und Stimmungsanalyse und berücksichtigen die sprachliche Vielfalt der zahlreichen Sprachen Indiens.

Computer Vision ist ein Bereich der Künstlichen Intelligenz, der Maschinen trainiert, die visuelle Welt so zu sehen, zu verstehen und zu interpretieren, wie es Menschen tun. Es hilft bei der Entwicklung von Modellen für maschinelles Lernen, um Objekte in einem Bild oder Video genau zu verstehen, zu identifizieren und zu klassifizieren – in einem viel größeren Maßstab und einer viel größeren Geschwindigkeit.

Erstellen und lokalisieren Sie KI-fähige Sprachmodelle mit umfangreichen strukturierten Datensätzen in mehreren Sprachen aus der ganzen Welt. Vollständig angepasste Absicht, Äußerungen und demografische Verteilung.

Menschliche Bewertung von LLMs und KI-Agenten durch geprüfte Fachexperten. Shaip entwickelt die Bewertungskriterien, führt die Bewertung durch, sichert die Qualität und liefert sofort einsatzbereite Ergebnisse – ohne Personalaufwand, ohne Marktplätze, ohne die Evaluatoren selbst zu verwalten.
