
Datensatz für maschinelles Lernen
Kaufen und lizenzieren Sie Premium-KI-Trainingsdatensätze | KI-Datenkatalog & Lizenzmarktplatz
Der KI-Datenkatalog und Lizenzmarktplatz von Shaip bietet KI-Teams eine zentrale Anlaufstelle für den Kauf und die Lizenzierung von vorab annotierten, kommerziell freigegebenen Trainingsdatensätzen in den Formaten Text, Sprache, Bild, Video und multimodal. Jeder Datensatz ist manuell annotiert, stammt aus ethisch einwandfreier Quelle und wird sofort für das Training bereitgestellt – inklusive vollständiger Dokumentation zur Einhaltung der DSGVO, HIPAA und der Anforderungen an die Daten-Governance von Unternehmen.
Ob Sie ein umfangreiches Sprachmodell optimieren, ein Diagnosesystem im Gesundheitswesen trainieren oder eine Bildverarbeitungspipeline beschleunigen möchten – Shaips Angebot deckt über 10 Branchen ab und bietet flexible Lizenzoptionen: Einmalkauf, Abonnement oder individuelle Unternehmensvereinbarungen. Fordern Sie einen kostenlosen Beispieldatensatz an, um sich vor einer endgültigen Entscheidung von der Qualität zu überzeugen.
Wir legen bei all unseren Aktivitäten Wert auf eine ethische Datenbeschaffung und sorgen so für eine verantwortungsvolle und faire KI-Entwicklung. Unsere strengen und transparenten Praktiken bei der Datenerfassung, -validierung und -verarbeitung schützen die Privatsphäre und erhalten das Vertrauen unserer Kunden und Datenlieferanten.
Katalog physikalischer KI-Daten
Der Erfolg von Roboterlernprogrammen hängt maßgeblich von der Qualität und Konsistenz ihrer Demonstrationsdaten ab. Unser Katalog für physikalische KI bietet menschliche Demonstrationen, multimodale Wahrnehmungsdaten und Roboterzustands-Aktions-Episoden, die anhand einer standardisierten Aufgabenbibliothek erfasst wurden. So erhalten Ihre VLA-, Humanoid-, Manipulations- und Real2Sim-Pipelines die sauberen, vergleichbaren Episoden, die sie für zuverlässiges Training und Evaluierung benötigen.
Standardisierter Katalog physikalischer KI-Daten und Lizenzierung:
- Mehr als 1,400 dokumentierte Aufgabenszenarien in 9 realen Umgebungen (Haushalt, Industrie, Einzelhandel, Gastgewerbe u. v. m.)
- Demonstrations- und VLA-Trainingsepisoden am Menschen mit einheitlichen Ausgangszuständen und Erfolgskriterien
- Egozentrische und Multiview-Videoaufnahmen mit Bewegungs-, Posen- und Geschicklichkeitserfassung
- Episodendauer von 0.5 bis 10 Minuten in 4 Schwierigkeitsstufen, inklusive Werkzeugnutzung

Sprachdatenkatalog
Es gibt eine Vielzahl von gängigen Anwendungen für Sprachdaten in KI-Projekten. Wir bieten Ihnen riesige Mengen an hochwertigen Daten für Ihre Spracherkennungsprodukte, die zu Ihrem Budget passen und mit Ihrem Wachstum skaliert werden können, um Ihre KI-/ML-Modelle zu trainieren.
Standardmäßiger Sprachdatenkatalog und Lizenzierung:
- Über 55 Stunden Sprachdaten (50+ Sprachen/100+ Dialekte)
- Über 70 behandelte Themen
- Abtastrate – 8/16/44/48 kHz
- Audiotyp -Spontan, geskriptet, Monolog, Worte zum Aufwachen
- Vollständig transkribierte Audiodatensätze in mehreren Sprachen für Mensch-Mensch-Gespräche, Mensch-Bot-Gespräche, Mensch-Agent-Callcenter-Gespräche, Monologe, Reden, Podcasts usw.
- Aussprachelexika, sowohl allgemein als auch domänenspezifisch (z. B. Namen, Orte, natürliche Zahlen)

Katalog medizinischer Daten
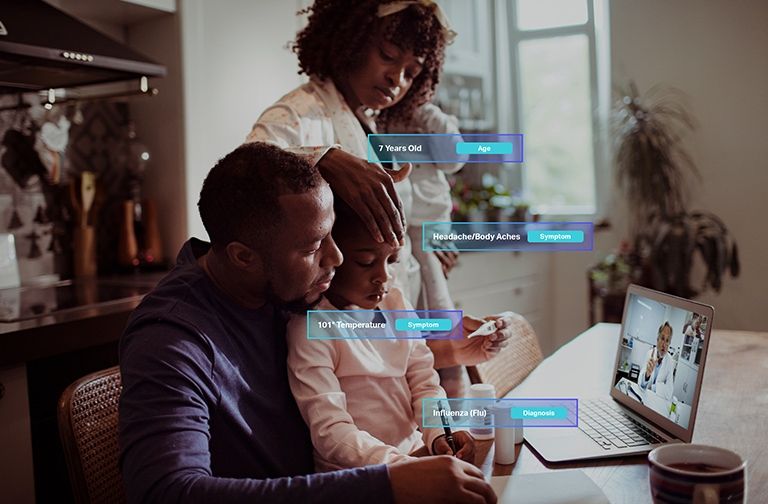
Unsere medizinischen Datenkatalog-Datensätze sind nicht nur riesig, sondern enthalten auch Daten in Goldstandard-Qualität. Seien Sie versichert, dass die von Ihnen verwendeten Daten sicher, anonymisiert und vertrauenswürdig sind, um die höchsten und genauesten Ergebnisse für Ihre KI-Initiative, maschinelle Lernmodelle, natürliche Sprachverarbeitung und andere Entwicklungsprojekte zu erzielen.
Standardmäßiger medizinischer Datenkatalog und Lizenzierung:
- Über 5 Millionen elektronische Patientenakten und Audiodateien von Ärzten in 31 Fachgebieten
- 2M+ Medizinische Bilder in der Radiologie und anderen Fachgebieten (MRTs, CTs, USGs, XRs)
- Über 30 klinische Textdokumente mit wertschöpfenden Entitäten und Beziehungsanmerkungen
Computer-Vision-Datenkatalog
Es gibt eine Vielzahl gängiger Anwendungen für Computer Vision in KI-Projekten. Wir bieten Ihnen riesige Mengen hochwertiger Bild- und Videodaten, die für Ihre Computer-Vision-Modelle bereitstehen, die zu Ihrem Budget passen und mit Ihrem Wachstum skaliert werden können.
Bild- und Videodatenkatalog & Lizenzierung:
- Bildsammlung von Lebensmitteln/Dokumenten
- Videosammlung zur Haussicherheit
- Sammlung von Gesichtsbildern/-videos
- Rechnungen, Bestellungen, Belegsammlung für OCR
- Bilderfassung für die Fahrzeugschadenserkennung
- Bildsammlung für Kfz-Kennzeichen
- Sammlung von Autoinnenbildern
- Bildsammlung mit Autofahrer im Fokus
- Modebezogene Bildersammlung
- Drohnenbasierte Videosammlung und -kommentierung
- Video-/Bildsammlung für behinderte Personen
- Landmark-Bildersammlung
- Bildsammlung zum Scannen von Barcodes

Textdatenkatalog
Große Sprachmodelle und NLP-Systeme benötigen Texte, die reale Sprache, reale Anwendungsbereiche und reale regionale Unterschiede widerspiegeln. Unser Textdatenkatalog bietet sofort lizenzierbare Textdatensätze in acht Kategorien: Konversationelle Fragen und Antworten, Code, Nachrichten, klinische Daten, Webtexte, gescannte Dokumente, akademische Texte und Unterhaltung. Sie eignen sich für Vortraining, Feinabstimmung, RAG-Klassifizierung und Evaluierung und können individuell an Ihr Projekt angepasst werden.
Standard-Textdatenkatalog & Lizenzierung:
- Mehr als 170 von Menschen verfasste Frage-Antwort-Paare in Englisch und Arabisch, die saudische, emiratische, ägyptische und levantinische Dialekte abdecken.
- Mehr als 50 Millionen Codezeilen in 9 Programmiersprachen, einige davon mit vollständiger Pull-Request- und Commit-Historie
- Ein Nachrichtenarchiv mit 975 Artikeln, das bis ins Jahr 1999 zurückreicht, sowie fortlaufende Newsfeeds in Englisch, Spanisch und Arabisch.
- Klinische Fragen und Antworten, Fallzusammenfassungen und Artikel, erhältlich als Gold-/Silber-Sets, mit Anonymisierung.
- 20 Millionen Wörter umfassender arabischer Rohtextkorpus sowie Prompt- und TTS-Skriptkorpora für das Vortraining
- Mehr als 1.3 Millionen Zeitschriftenartikel und über 4,100 Buchtitel aus 12 naturwissenschaftlichen und ingenieurwissenschaftlichen Fachgebieten
- Gescannte Dokumente und Formulare aus der Praxis (über 12 PDFs) für Dokumenten-KI und Informationsextraktion
- Mehr als 90 Stunden an Drehbuchmaterial für Film, Fernsehen, Animation und Kurzfilme zur Erstellung von Erzähl- und Dialogmodellen
Offene Datensätze
Durch die Shaip-Bibliothek mit offenen Datensätzen hat Ihr Team freien Zugriff auf ein umfangreiches KI-Daten-Repository. Jetzt können Sie Ihre KI- und ML-Modelle schnell und präzise auf Ihre spezifischen Geschäftsergebnisse hin entwickeln, ohne dass damit verbundene Kosten anfallen.
Verfügbare offene Datensätze:
- Erhältlich in einer praktischen und modifizierbaren Form
- Riesige Kategorien von Datensätzen
- Kostenlos zur Verwendung mit Ihren KI- und ML-Projekten
- Hochwertige Daten nach Goldstandard

Sicherheit & Compliance


Vereinbaren Sie eine Demo, um zu erfahren, wie Shaip alle Ihre Trainingsdatenanforderungen erfüllen kann.
Von der Datenerfassung über die Annotation und Lizenzierung bis hin zur Validierung – wir helfen Ihnen, schneller auf den Markt zu kommen, mit Daten, denen Sie vertrauen können.
KontaktHäufig gestellte Fragen (FAQ)
1. Was ist eine Datenkataloglizenzierung?
Mit der Datenkataloglizenzierung können Unternehmen kuratierte Datensätze für den Einsatz in KI-Projekten erwerben oder lizenzieren. Diese Datensätze umfassen Text-, Sprach-, Bild- oder Videodaten, die sorgfältig aufbereitet sind, um spezifische Anforderungen zu erfüllen. Die Lizenzierung stellt sicher, dass Unternehmen die Daten legal nutzen und gleichzeitig Datenschutz- und Compliance-Standards einhalten können.
2. Wie werden die KI-Trainingsdatensätze von Shaip gesammelt und beschriftet?
Shaip sammelt Daten über ein globales, verifiziertes Netzwerk von Mitwirkenden in über 60 Ländern mithilfe der firmeneigenen Erfassungsplattform. Alle Datensätze durchlaufen vor der Auslieferung eine mehrstufige Qualitätssicherung durch Fachexperten, automatisierte Validierungsprüfungen und eine abschließende manuelle Überprüfung. Die Genauigkeit der Kennzeichnung liegt in allen Katalogkategorien bei über 95 %.
3. Kann Shaip Datensätze skalieren, um wachsenden Projektanforderungen gerecht zu werden?
Ja, die Datensätze von Shaip sind skalierbar. Ob Sie kleine Datensätze für Tests oder große Mengen zum Trainieren unternehmenstauglicher KI-Modelle benötigen – das globale Netzwerk von Shaip liefert Ihnen die Daten, die den Anforderungen Ihres Projekts gerecht werden.
4. Wie viel kostet die Lizenzierung von Standard-Datensätzen?
Die Lizenzkosten hängen von Faktoren wie Datentyp, Volumen, Anpassung und Nutzungsrechten ab. Shaip bietet flexible Preise für unterschiedliche Budgets und Projektanforderungen. Kontaktieren Sie das Team für ein individuelles Angebot.
5. Kann ich einen Beispieldatensatz anfordern?
Ja, Shaip bietet Beispieldatensätze an, mit denen Sie die Datenqualität und Relevanz für Ihr Projekt beurteilen können. Kontaktieren Sie das Team, um eine Demo zu vereinbaren oder ein Beispiel anzufordern.
6. Wo kann ich lizenzierte KI-Trainingsdatensätze für die kommerzielle Nutzung erwerben?
Der KI-Datenkatalog von Shaip bietet vorab gelabelte Datensätze zur sofortigen kommerziellen Lizenzierung in den Formaten Text, Sprache, Bild, Video und multimodale Daten. Alle Datensätze enthalten eine klare, DSGVO- und HIPAA-konforme Lizenzdokumentation mit Optionen für Einmalkauf, Jahresabonnement oder Unternehmensvertrag. Fordern Sie ein kostenloses Muster an, um sich vor dem Kauf von der Qualität zu überzeugen.
7. Wie kann ich DSGVO- und HIPAA-konforme Datensätze für das Training von KI-Modellen erwerben?
Der gesamte Datensatzkatalog von Shaip erfüllt die Anforderungen der DSGVO und des HIPAA. Jeder Datensatz enthält Einwilligungsdokumente, anonymisierte Datensätze (für medizinische Daten), Metadaten zur Datenherkunft und revisionssichere Compliance-Dokumente. Organisationen, die den Richtlinien der DSGVO, des HIPAA, des CCPA oder der ISO 27001 unterliegen, können Datensätze inklusive vollständiger Dokumentation ohne zusätzliche Kosten lizenzieren.
8. Welche Arten von vorab gelabelten multimodalen Datensätzen kann ich von Shaip lizenzieren?
Shaip bietet multimodale Datensätze, die Text-, Sprach-, Bild- und Videodaten kombinieren – darunter egozentrische Videos für Physical AI, Datensätze mit menschlichen Demonstrationen für Robotik und kombinierte Text-Bild-Korpora für das GenAI-Feintuning. Alle multimodalen Datensätze enthalten Metadaten, Annotationen auf Modalitätsebene und kommerzielle Lizenzbedingungen. Kostenlose Beispiele sind auf Anfrage erhältlich.
