Datengesteuerte Entscheidungsfindung ist heute das Mantra für Unternehmenserfolg und Spitzenleistung. Von Fintech und Fertigung bis hin zu Einzelhandel und Lieferketten – jede Branche reitet auf der Big-Data-Welle und trifft mit ihren fortschrittlichen Analysemodellen und Algorithmen statistisch fundierte Entscheidungen. Im Gesundheitsbereich ist dies umso lohnender und lebensrettender und dient als Grundlage für Innovation und wissenschaftlichen Fortschritt.
Mit einem so enormen Umfang gehen auch Herausforderungen einher. Da die Nachfrage nach Gesundheitsdaten für verschiedenste Zwecke rasant steigt, nimmt auch das Risiko von Datenschutzverletzungen und dem Missbrauch sensibler Informationen zu. Ein Bericht aus dem Jahr 2023 zeigt , dass über 133 Millionen medizinische Datensätze gestohlen wurden – ein neuer Rekord für Datenschutzverletzungen im Gesundheitswesen.
Die Verabschiedung der HIPAA-Richtlinie war ein beruhigender Schritt zur Optimierung des Datenschutzes im Gesundheitswesen , der die Zahl der Datenschutzverletzungen um 48 % deutlich reduzierte . Berichten zufolge sind 61 % aller Datenschutzverletzungen auf Fahrlässigkeit von Mitarbeitern und Fachkräften in diesem Bereich zurückzuführen.
Um solche Angriffe und die massenhafte Offenlegung von Sicherheitslücken weiter einzudämmen, kommen synthetische Patientendaten zum Einsatz . Getreu dem Motto „Moderne Probleme erfordern moderne Lösungen“ ermöglicht der Einsatz synthetischer Daten im Gesundheitswesen medizinischem Fachpersonal, Patientendaten zu verbessern und KI-Modelle zur Generierung neuer Daten zu nutzen.
In diesem Artikel werden wir uns eingehend mit der Generierung synthetischer Daten und ihren vielfältigen Aspekten auseinandersetzen .
Synthetische Patientendaten: Was ist das?
Synthese ist der Prozess, etwas Neues durch die Kombination vorhandener Elemente zu schaffen. Im gleichen Kontext beziehen sich synthetische Patientendaten auf künstlich erzeugte Daten aus bereits vorhandenen realen Patientendaten.
In diesem Prozess untersuchen statistische Modelle und Algorithmen große Mengen an Patientendaten, beobachten Muster und Merkmale und generieren Datensätze, die reale Daten emulieren. Zu den gängigen Techniken, die bei der Generierung künstlicher Patientendaten eingesetzt werden, gehören:
- Generative Adversarial Networks (GNNs)
- Statistische Modelle
- Methoden zur Datenanonymisierung und mehr
Synthetische Daten sind eine hervorragende und wasserdichte Methode, um Datenschutzbedenken im Zusammenhang mit der Möglichkeit der Offenlegung wiederidentifizierbarer Patienteninformationen auszuräumen. Um die Vorteile solcher Daten zu verstehen, schauen wir uns einige der bekanntesten Anwendungsfälle an.
Anwendungsfälle für synthetische Daten
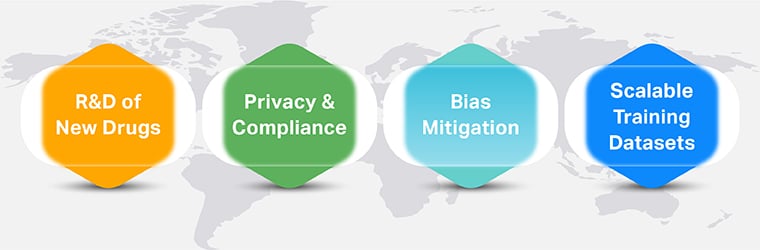
Forschung und Entwicklung neuer Arzneimittel und Medikamente
Die Datengenerierung in klinischen Studien erfolgt diskret, und Organisationen halten oft wichtige Informationen zurück. Für Forschung und Entwicklung ist die Interoperabilität von Daten jedoch entscheidend für bahnbrechende Erkenntnisse. Die Generierung synthetischer Daten kann Forschern helfen, wichtige, nachvollziehbare Informationen zu verbergen und Daten aus verschiedenen Datenquellen zusammenzuführen, um gemeinsam Arzneimittelwirkungen und -konkurrenten, Formulierungen, Korrelationen, Ergebnisse und vieles mehr zu untersuchen.
Datenschutz und Einhaltung gesetzlicher Vorschriften
Während über die Notwendigkeit zentralisierter, cloudbasierter EHR-Systeme diskutiert wird, gibt es auch regulatorische Herausforderungen in Bezug auf Datenschutz und Sicherheit. Obwohl Dateninteroperabilität unvermeidlich ist, müssen die Beteiligten im gesamten Gesundheitswesen beim Teilen von Patientendaten äußerst wachsam sein. Synthetische Daten können helfen, sensible Aspekte zu verbergen, während gleichzeitig wichtige Berührungspunkte erhalten bleiben und sie als ideale repräsentative Datensätze dienen.
Vorurteilsminderung im Gesundheitswesen
Im Gesundheitswesen ist die Einführung von Voreingenommenheit angeboren und unvermeidlich. Wenn beispielsweise in einem geografischen Gebiet eine Epidemie ausbricht, von der Männer im Alter zwischen 35 und 50 Jahren betroffen sind, kommt es automatisch zu Voreingenommenheit gegenüber dieser spezifischen Person. Obwohl Frauen und Kinder immer noch anfällig für diesen Ausbruch sind, benötigen Forscher eine objektive Grundlage, um ihre Ergebnisse zu untermauern. Synthetische Daten können dazu beitragen, Voreingenommenheit zu beseitigen und ausgewogene Darstellungen zu liefern.
Skalierbare Trainingsdatensätze für das Gesundheitswesen
Aufgrund von Vorschriften wie der DSGVO, HIPAA und anderen ist die Verfügbarkeit von Datensätzen zum Trainieren fortgeschrittener, gesundheitsbezogener maschineller Lernmodelle nach wie vor begrenzt. Künstliche Intelligenz (KI)-Systeme und maschinelle Lernmodelle benötigen enorme Mengen an Trainingsdaten, um immer bessere und genauere Ergebnisse liefern zu können.
Die Erzeugung synthetischer Daten ist in diesem Bereich ein Segen, da sie es Organisationen ermöglicht, künstliche Daten zu generieren, die auf ihre Volumenanforderungen, Spezifikationen und Ergebnisse zugeschnitten sind, und gleichzeitig den ethischen Umgang mit synthetischen Daten fördert.
Mängel und Fallstricke synthetischer Gesundheitsdaten
Die Tatsache, dass es Systeme und Module gibt, mit denen Patienten- und Gesundheitsdaten aus vorhandenen Datensätzen künstlich generiert werden können, ist beruhigend. Allerdings ist diese Technik nicht ohne Mängel. Lassen Sie uns verstehen, welche das sind.