Stellen Sie sich vor, Sie unterhalten sich mit Ihrem Smartphone, hören sich beim Autofahren Ihre Lieblingsartikel vorgelesen an oder lernen eine neue Sprache mit perfekter Aussprache – und das alles ohne menschliches Eingreifen. Das ist die Magie der Text-to-Speech-Technologie (TTS).
Unternehmen investieren verstärkt in Text-to-Speech (TTS), insbesondere nach dem KI-Boom. Der TTS-Markt hatte 2023 einen Wert von 3.2 Milliarden US-Dollar und wird voraussichtlich bis 2030 auf 7 Milliarden US-Dollar anwachsen, was einer durchschnittlichen jährlichen Wachstumsrate (CAGR) von 12 % entspricht.
Was als einfache Funktion begann, hat sich mittlerweile zu etwas völlig anderem entwickelt – Konversations-KI. Text-to-Speech ist dieselbe Technologie, die heute in virtuellen Assistenten, Kundenservice-Bots usw. zum Einsatz kommt. In diesem Leitfaden erklären wir Ihnen alles, was Sie über Text-to-Speech wissen müssen.
Aber was ist Text-to-Speech und wie funktioniert es?
Im Kern geht es bei der Text-to-Speech-Technologie (TTS) darum, dem Text eine Stimme zu geben. Einfach ausgedrückt wird der Text als Eingabe verwendet, der jede beliebige Form haben kann, z. B. ein Satz, ein Absatz oder ein ganzes Dokument, und in gesprochene Sprache umgewandelt. Die generierte Stimme ähnelt größtenteils der menschlichen Stimme, kann jedoch von Produkt zu Produkt unterschiedlich sein.
Ein gutes Beispiel ist, dass die Stimme des Google Assistant roboterhaft klingt, andererseits kommen moderne KI-Tools wie hume.ai der menschlichen Stimme sehr nahe.
Wie jede andere Technologie wurde auch die TTS-Technologie mit der Zeit komplexer, da mehrere KI- und ML-Algorithmen hinzugefügt wurden, um ihre Leistungsfähigkeit zu verbessern. Zu Ihrer Bequemlichkeit haben wir die Funktionsweise von Text-to-Speech in drei Teile unterteilt.
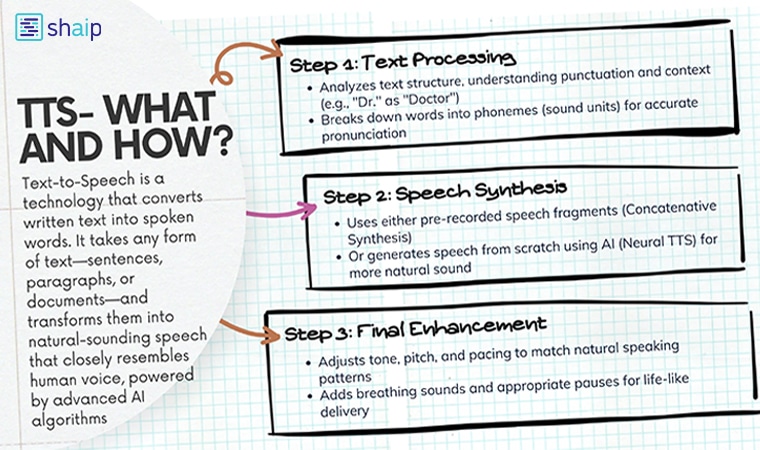
Schritt 1: Textverarbeitung
Dies ist der erste Schritt, bei dem das TTS-System den Text für die Sprachausgabe vorbereitet. Folgendes passiert:
- Analyse des Textes: Das System scannt zunächst den Text, um seine Struktur zu verstehen, die alles von Satzzeichen, Abkürzungen bis hin zu Zahlen umfasst. Auf diese Weise kann das System den Kontext besser verstehen. Ein gutes Beispiel ist, dass „Dr.“ als „Doctor“ und nicht als „Drive“ erkannt wird.
- Wörter zerlegen: Später werden Wörter in ihre phonetischen Bestandteile zerlegt, die so genannten Phoneme. Dies ist einer der entscheidenden Schritte, um eine korrekte Aussprache sicherzustellen. Dies sind die kleinsten Lauteinheiten in der Sprache. Ein gutes Beispiel für die Aufteilung von Wörtern in Phoneme ist das Wort „cat“, das drei Phoneme hat: /k/, /æ/ und /t/.
- Umgang mit Kontext: In diesem Schritt lernt das System den Kontext des Textes, um zu entscheiden, wie Wörter ausgesprochen werden. Beispielsweise könnte das Wort „lead“ in „lead a team“ anders ausgesprochen werden als in „lead pipe“.
Schritt 2: Sprachsynthese
Sobald der Text verarbeitet ist, besteht der nächste Schritt darin, ihn in tatsächliche Sprache umzuwandeln. Dies geschieht mithilfe einer von zwei Hauptmethoden:
- Verkettete Synthese: Dies ist eine traditionelle Methode, die schon sehr lange verwendet wird. Der Vorgang ist recht einfach: Sie verwenden vorher aufgezeichnete Fragmente menschlicher Sprache und fügen sie zu einem Satz zusammen.
Um beispielsweise „Hallo Welt“ zu sagen, könnte das System den voraufgezeichneten Ton für „Hallo“ und „Welt“ verwenden und diese dann zu einem Satz zusammenfügen. Das ist zwar effektiv, hat aber den großen Nachteil, dass der generierte Ton abgehackt oder roboterhaft klingen kann, insbesondere bei komplexen Sätzen. - Neuronales TTS (moderner Ansatz): Anders als bei der vorherigen Methode, bei der das System vorab aufgezeichnete Clips zusammenfügte, handelt es sich bei Neural TTS um eine moderne Methode, bei der künstliche Intelligenz und Deep Learning zur Sprachgenerierung von Grund auf eingesetzt werden.
Wenn Sie beispielsweise „Hallo Welt“ sagen, generiert die neuronale Netzwerktechnik den gesamten Satz in einem nahezu natürlichen Ton, der auch emotional und flektierend ist. Aus diesem Grund gibt es hinsichtlich der Sprachqualität zwischen alter und neuer TTS-Software himmelweite Unterschiede.
Dieser Ansatz erzeugt eine äußerst realistische, ausdrucksstarke und menschenähnliche Sprache und ist daher heutzutage die bevorzugte Wahl für viele fortschrittliche TTS-Systeme.
Schritt 3: Den letzten Schliff geben
Im letzten Schritt verleiht das TTS-System der Ausgabe den letzten Schliff:
- Ton und Tonhöhe: Dies wird getan, um Emotionen oder Betonung auszudrücken. Aufregung wird beispielsweise durch eine höhere Tonlage ausgedrückt, während Ernsthaftigkeit durch einen tieferen Ton zum Ausdruck gebracht wird.
- Pacing: Die Sprechgeschwindigkeit wird basierend auf dem Textkontext an das natürliche Sprechmuster angepasst.
- Atmung und Pausen: Dies ist meiner Meinung nach das Wichtigste, da diese fortschrittlichen Systeme mithilfe von KI und ML natürliche Atemgeräusche und Pausen simulieren und die Ausgabe dadurch lebensechter machen. Das beste Beispiel ist, wie NotebookLM Audio aus Text in Gesprächsform mit Atem und Pausen generiert das die menschliche Sprechweise genau nachahmt.
Welche Rolle spielt KI bei TTS?
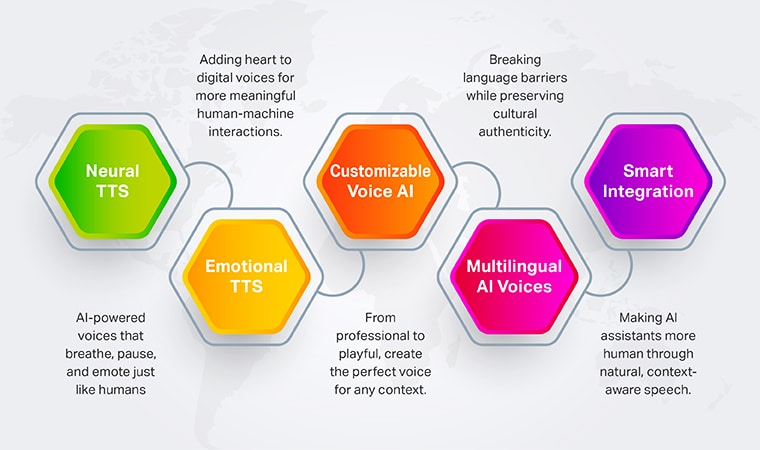
Wir glauben, dass KI die TTS-Technologie revolutioniert hat und uns wichtige Funktionen ermöglicht hat, die wir täglich nutzen, wie die Fähigkeit, realistische und natürlich klingende Sprache zu produzieren. Neben diesen Funktionen hat sich auch die Genauigkeit erheblich verbessert.
Hier sind die wichtigsten Beiträge der KI zur TTS-Technologie:
- Neuronales TTS für menschenähnliche Stimmen: Dies ist bei weitem der wichtigste Beitrag der KI zu TTS. Dank KI erleben wir jetzt neuronales TTS, das nicht nur menschliche Sprache imitiert, sondern auch Emotionen, Pausen und Tiefe bietet, die ohne KI nicht möglich sind. Im Gegensatz zu herkömmlichen Methoden erzeugt es flüssige, lebensechte Stimmen, ohne auf voraufgezeichnete Segmente angewiesen zu sein.
- Emotionale Berührung: Mit KI können Text-to-Speech-Systeme Audio mit Emotionen erzeugen. Dies ist insbesondere dann nützlich, wenn Sie mit einem Chatbot sprechen und dieser eine eindringliche Stimme hat, die sowohl für Unternehmen als auch für Benutzer von Vorteil ist. Aus diesem Grund werden heute immer mehr TTS-Systeme beim Geschichtenerzählen, in der Therapie und bei virtuellen Assistenten eingesetzt.
- Anpassbare KI-Stimmen: Seit der Integration von KI in TTS können Sie personalisierte Stimmen für den persönlichen und professionellen Gebrauch erstellen, da der Ton einfach nach Bedarf geändert werden kann. Unternehmen können beispielsweise empathische Modelle mit Tönen erstellen, die diesem Anwendungsfall entsprechen. Wenn eine Einzelperson jedoch etwas zum Spaß erstellen möchte, kann sie ein Modell erstellen, das wie JARVIS klingt, ein vom Film inspiriertes Tool.
- Mehrsprachigkeit und Akzentunterstützung: Mithilfe künstlicher Intelligenz können TTS-Systeme mehrere Sprachen problemlos verstehen und in mehreren Sprachen antworten. Auf diese Weise können Unternehmen Inklusivität und Zugänglichkeit für ein globales Publikum gewährleisten. Das Beste daran ist jedoch, dass sich das System auch an regionale Nuancen anpasst, was letztendlich die Identifikation verbessert.
- Integration mit Conversational AI: TTS ist in Verbindung mit KI zu einem integralen Bestandteil moderner KI-Assistenten wie Alexa und Siri geworden. Es stellt sicher, dass diese Assistenten Antworten liefern, die gesprächsorientiert, ansprechend und kontextbezogen sind.
Herausforderungen für Unternehmen bei der Entwicklung von TTS
Trotz moderner Technologie stehen Unternehmen vor zahlreichen Herausforderungen, wenn sie das wahre Potenzial von TTS entwickeln und nutzen möchten. Hier sind einige der Hauptprobleme:
- Datenverfügbarkeit und -qualität: Das Ergebnis des TTS-Systems hängt in hohem Maße von der Qualität der Datensätze ab und Unternehmen benötigen große Mengen an Qualitätsdaten, die schwer zu finden und deren Anschaffung teuer ist.
- Natürlichkeit und Ausdruckskraft erreichen: Dies ist eines der größten Probleme, mit denen Unternehmen konfrontiert sind: Natürlichkeit und Ausdrucksstärke zu erreichen. Während moderne KI- und ML-Algorithmen dieses Problem weitgehend gelöst haben, können diese Systeme kontextsensitive Ausdrücke wie Sarkasmus oder Aufregung oft nicht reproduzieren.
- Hoher Rechenaufwand: Wenn Sie fortgeschrittene TTS-Modelle entwickeln möchten, die auf KI basieren, ähnlich wie Tacotron or Wellennetz, machen Sie sich darauf gefasst, eine Menge Geld für Rechenleistung auszugeben. Diese fortschrittlichen TTS-Systeme erfordern moderne GPUs für Inferenz und Training, was sich für kleine Organisationen als großes Problem erweisen könnte.
- Mehrsprachige und regionale Anpassung: Der Aufbau eines TTS-Systems, das mehrere Sprachen und Akzente versteht, ist ein großes Problem. Aus diesem Grund entwickeln Unternehmen häufig mehrere TTS für mehrere Sprachen und führen sie zusammen, um dieses Problem zu lösen. Selbst eine solche Lösung kann dieses Problem möglicherweise nicht zu 100 % lösen.
Wie kann Shaip Text-to-Speech für Sie neu definieren?
Egal, ob Sie virtuelle Assistenten, interaktive Sprachantwortsysteme oder KI-gesteuerte Sprachanwendungen entwickeln, Shaip steht Ihnen zur Seite. Wir verfügen über Fachwissen in der Erfassung und Verarbeitung von Sprachdaten, sodass Ihre TTS-Systeme nicht nur präzise, sondern auch natürlich und relevant klingen.
So kann Shaip Ihre TTS-Projekte verbessern:
- Benutzerdefinierte TTS-Datenlösungen: Shaip bietet Ihnen maßgeschneiderte TTS-Datensätze die den spezifischen Anforderungen Ihres Projekts entsprechen. Von Aufnahmen in Studioqualität bis hin zu realen Szenarien werden die Daten sorgfältig kuratiert, um die Klarheit und Flüssigkeit der generierten Sprache zu verbessern.
- Hochwertiger Sprachdatenkatalog: Bei Shaip haben Sie Zugriff auf eine sehr großer Sprachdatenkatalog und erhalten Sie vormarkierte Sprachdatensätze aus dem riesigen Repository. Ethisch bezogene Datensätze mit Metadaten stellen sicher, dass Sie Trainingsdaten in bester Qualität für Ihre KI-Modelle erhalten.
- Expertenbewertung und -unterstützung: Wir gehen einen Schritt über die Bereitstellung von Daten hinaus. Wir bieten auch Evaluierungsdienste an, die sicherstellen, dass TTS den hohen Standards hinsichtlich natürlicher Sprache und Genauigkeit entspricht.
Durch die Zusammenarbeit mit Shaip erhalten Sie Zugriff auf erstklassige Sprachdatenlösungen, die das Ergebnis Ihres nächsten TTS-Systems deutlich verbessern. Egal, ob Sie nach benutzerdefinierten Datensätzen oder vorgefertigten Lösungen suchen, Sie fragen uns und wir sorgen dafür, dass es für Sie funktioniert.