Large Language Models (LLMs) wie GPT-4 und Llama 3 haben die KI-Landschaft beeinflusst und Wunder vollbracht, vom Kundenservice bis zur Inhaltsgenerierung. Die Anpassung dieser Modelle an spezifische Anforderungen bedeutet jedoch normalerweise, dass man sich zwischen zwei leistungsstarken Techniken entscheiden muss: Retrieval-Augmented Generation (RAG) und Feinabstimmung.
Beide Ansätze verbessern zwar LLMs, verfolgen jedoch unterschiedliche Ziele und sind in unterschiedlichen Situationen erfolgreich. Lassen Sie uns die Vor- und Nachteile dieser beiden Methoden im Detail untersuchen und wie man eine Methode für seine Bedürfnisse auswählen kann.
Retrieval-Augmented Generation (RAG) – was ist das?
RAG ist ein Ansatz, der die generativen Fähigkeiten von LLMs mit der Suche nach kontextuell präzisen Antworten kombiniert. Anstatt nur das getestete Wissen zu verwenden, bezieht RAG relevante Informationen aus externen Datenbanken oder Wissensrepositorien in den Antwortgenerierungsprozess ein.
So funktioniert RAG
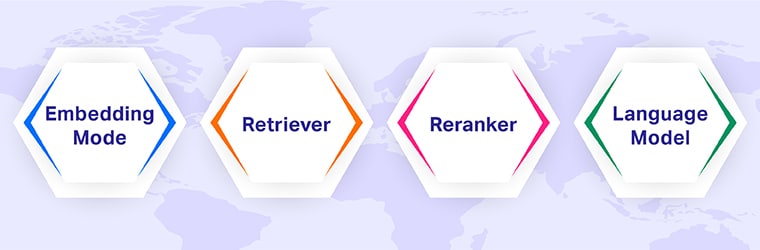
- Einbettungsmodell: Bettet sowohl die Dokumente als auch die Abfragen in den Vektorraum ein, um einen Vergleich effizienter zu gestalten.
- Retriever: Durchsucht eine Wissensdatenbank über Einbettungen, um relevante Dokumente zu erfassen.
- Neuranker: Bewertet die abgerufenen Dokumente nach ihrer Relevanz.
- Sprachmodell: Fügt abgerufene Daten mit den Abfragen eines Benutzers zu einer Antwort zusammen.
Vorteile von RAG
- Dynamische Wissens-Upgrades: Bietet einen effizienten Informationsfluss, wobei die Aktualisierungsprozesse durch den Prozess der Modellneuschulung erheblich reduziert werden.
- Verringerung der Halluzination: Indem die Antworten von RAG auf externes Wissen gestützt werden, minimiert das Unternehmen sachliche Ungenauigkeiten.
- Skalierbarkeit: Kann leicht in große, vielfältige Datensätze eingebettet werden und bietet dadurch Optionen für nützliche offene und dynamische Aufgaben, wie etwa Kundenbetreuung und Nachrichtenzusammenfassungen.
Einschränkungen von RAG
- Latenz: Die größte Aufmerksamkeit bei der Informationsextraktion verzögert die Ausgabezeit, was zu einer höheren Latenz führt und es für Echtzeit-Arbeitsumgebungen irrelevant macht.
- Qualität der Wissensdatenbank: Die Zuverlässigkeit beim Abrufen und die Relevanz externen Wissens werden wichtig, da die Antworten ausschließlich von diesen Quellen abhängen.
Feinabstimmung – was ist das?
Feinabstimmung ist ein Prozess, bei dem ein vorab trainiertes LLM anhand eines bestimmten Domänendatensatzes zur Vorbereitung der Ausführung spezialisierter Aufgaben erneut trainiert wird. Dadurch kann das Modell nuancierte Muster, die innerhalb der Grenzen eines bestimmten Kontexts existieren, vollständig verstehen.
Wie Feinabstimmung funktioniert
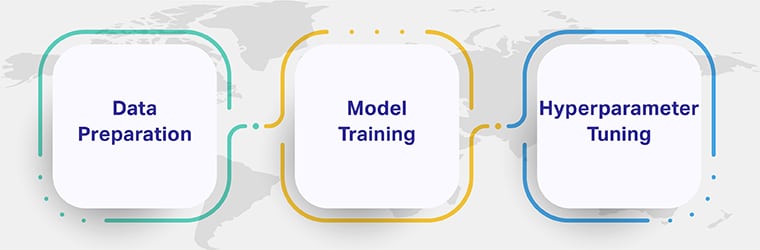
- Datenaufbereitung: Aufgabenspezifische Datensätze müssen bereinigt und in Trainings-, Validierungs- und Test-Untergruppen unterteilt werden.
- Modelltraining: Der LLM muss mit diesem Datensatz mit Methoden trainieren, die Backpropagation und Gradientenabstieg umfassen.
- Inhalte des Hyperparameter-Tunings: Ermöglicht die Feinabstimmung einiger kritischer Hyperparameterinhalte, beispielsweise Batchgröße und Lernrate.
Vorteile der Feinabstimmung
- Anpassung: Ermöglicht Kontrolle über die Aktionen, den Ton und den Stil des Modells in den Ausgaben.
- Effizienz bei der Inferenz: Wenn ein LLM fein abgestimmt wurde, erzeugt es schnelle Antworten ohne einen externen Abrufprozess.
- Spezialisierte Fähigkeiten: Am besten geeignet für Anwendungen, die Qualität und Genauigkeit in gut verstandenen Bereichen erfordern, wie z. B. Einfrieren, medizinische Untersuchungen und Vertragsanalysen.
Nachteile der Feinabstimmung
- Ressourcenintensiv: Erfordert sowohl große Rechenleistung als auch ausreichend hochwertige gekennzeichnete Daten.
- Katastrophales Vergessen: Durch die Feinabstimmung wird tendenziell zuvor erworbenes allgemeines Wissen überschrieben und dadurch das Potenzial des Wissens zur Bewältigung neuer Aufgaben eingeschränkt.
- Statische Wissensdatenbank: Nach Abschluss der Schulung bleibt das Wissen erhalten, sofern es nicht anhand zusätzlicher, neuer Daten erneut vermittelt wird.
Wichtige Unterschiede zwischen RAG und Feinabstimmung
| Funktion | Retrieval-Augmented Generation (LAPPEN) | Feintuning |
|---|---|---|
| Wissensquelle | Externe Datenbanken (dynamisch) | Während des Trainings internalisiert (statisch) |
| Anpassungsfähigkeit an neue Daten | Hoch; Updates über externe Quellen | Niedrig; erfordert Umschulung |
| Latency | Höher aufgrund von Abrufschritten | Niedrig; direkte Reaktionsgenerierung |
| Anpassung | Begrenzt; basiert auf externen Daten | Hoch; auf spezifische Aufgaben zugeschnitten |
| Skalierbarkeit | Einfache Skalierung mit großen Datensätzen | Ressourcenintensiv im großen Maßstab |
| Anwendungsbeispiele | Fragen und Antworten in Echtzeit, Faktenprüfung | Sentimentanalyse, domänenspezifische Aufgaben |