

Die Erkennung benannter Entitäten (Named Entity Recognition, NER) identifiziert und klassifiziert Textabschnitte in vordefinierte Kategorien. NER ist eine Technik der natürlichen Sprachverarbeitung (Natural Language Processing, NLP), die wichtige Informationen in unstrukturierten Texten findet und sie entsprechend kennzeichnet – beispielsweise als Person, Organisation, Ort, Datum oder Geldbetrag. Die NER-Abkürzung steht für Named Entity Recognition und ist zentral für die Umwandlung von Rohdaten in strukturierte, nutzbare Daten.
Warum ist das gerade jetzt wichtig? Weil der Wert von Texten rasant wächst. Der globale Markt für natürliche Sprachverarbeitung (NLP ) wurde 2024 auf 59.70 Milliarden US-Dollar geschätzt und soll bis 2030 auf 439.85 Milliarden US-Dollar anwachsen – ein jährliches Wachstum von 38.7 % (Grand View Research, 2024) . Named Entity Recognition (NER) ist eine der wichtigsten Aufgaben, die dieses Wachstum vorantreiben und Suchmaschinen, Chatbots und klinische Datenverarbeitungssysteme im Hintergrund unterstützen.
Stellen Sie sich NER wie einen Textmarker vor, der zwei Funktionen gleichzeitig erfüllt: Er markiert die wichtigen Wörter und schreibt eine Notiz an den Rand, die deren Bedeutung erklärt. Menschen tun dies instinktiv. Hören Sie „Steve Jobs“, verbinden Sie sofort die Begriffe Person, Apple und Kalifornien. Ein Computer besitzt diesen Instinkt nicht – er muss trainiert werden, diese Kategorien zu erkennen, und genau hier leistet die Qualität der Daten die Hauptarbeit.
Im Gesundheitswesen extrahiert die klinische NER Krankheitszustände, Medikamente, Dosierungen, Verfahren, anatomische Lokalisationen, Laborwerte und zeitliche Ausdrücke aus unstrukturierten Notizen und normalisiert diese anschließend auf Standards wie ICD-10-CM, CPT, SNOMED CT und RxNorm, sodass die Ausgabe maschinenlesbar und überprüfbar ist.
Wichtige Erkenntnisse
- NER identifiziert und klassifiziert Entitäten – Personen, Organisationen, Orte, Daten – in Texten.
- Die Abkürzung „NER“ steht für Named Entity Recognition, eine Kernaufgabe der natürlichen Sprachverarbeitung.
- Moderne NER-Systeme basieren hauptsächlich auf Deep Learning und Transformer-Modellen wie BERT.
- Tagging-Systeme wie BIO und IOBES kennzeichnen den Anfang und das Ende jeder Entität.
- Die Qualität der NER hängt von qualitativ hochwertigen, gut annotierten Trainingsdaten ab.
- Häufige Anwendungsbereiche: Suche, Chatbots, Gesundheitsakten, Finanzen und Rechtsprüfung.
Was ist Named Entity Recognition (NER)?
Die Erkennung benannter Entitäten (Named Entity Recognition, NER ) ist ein Teilgebiet der natürlichen Sprachverarbeitung (Natural Language Processing, NLP). Ihr Hauptziel ist die Verarbeitung strukturierter und unstrukturierter Daten und die Klassifizierung dieser benannten Entitäten in vordefinierte Kategorien. Zu den gängigen Kategorien gehören beispielsweise Name, Ort, Unternehmen, Zeit, Geldwert und Ereignis.
Kurz gesagt befasst sich NER mit:
- Erkennung/Erkennung benannter Entitäten – Identifizieren eines Wortes oder einer Reihe von Wörtern in einem Dokument.
- Klassifizierung benannter Entitäten – Klassifizierung aller erkannten Entitäten in vordefinierte Kategorien.
Aber wie hängt NER mit NLP zusammen?
Die Verarbeitung natürlicher Sprache (NLP) trägt zur Entwicklung intelligenter Maschinen bei, die in der Lage sind, Bedeutung aus Sprache und Text zu extrahieren. Maschinelles Lernen unterstützt diese intelligenten Systeme dabei, durch das Training mit großen Mengen an NLP- Datensätzen kontinuierlich dazuzulernen.
Im Allgemeinen besteht NLP aus drei Hauptkategorien:
- Den Aufbau und die Regeln der Sprache verstehen – Syntax
- Bedeutung von Wörtern, Text und Sprache ableiten und ihre Beziehungen erkennen – Semantik
- Gesprochene Wörter identifizieren und erkennen und in Text umwandeln - Rede
NER hilft im semantischen Teil von NLP, indem es die Bedeutung von Wörtern extrahiert, sie anhand ihrer Beziehungen identifiziert und lokalisiert.
Ein tiefer Einblick in gängige NER-Entitätstypen
Named Entity Recognition-Modelle kategorisieren Entitäten in verschiedene vordefinierte Typen. Das Verständnis dieser Typen ist entscheidend, um NER effektiv nutzen zu können. Hier ist ein genauerer Blick auf einige der gängigsten:
- Person (PER): Identifiziert die Namen von Personen, einschließlich Vor-, Mittel- und Nachnamen, Titeln und Ehrentiteln. Beispiel: Nelson Mandela, Dr. Jane Doe
- Organisation (ORG): Erkennt Unternehmen, Institutionen, Regierungsbehörden und andere organisierte Gruppen. Beispiel: Google, Weltgesundheitsorganisation, Vereinte Nationen
- Standort (LOC): Erkennt geografische Standorte, einschließlich Länder, Städte, Staaten, Adressen und Sehenswürdigkeiten. Beispiel: London, Mount Everest, Times Square
- Datum (DATUM): Extrahiert Daten in verschiedenen Formaten. Beispiel: 1. Januar 2024, 2024-01-01
- Zeit Zeit): Identifiziert Zeitangaben. Beispiel: 3:00 Uhr, 15:00
- Menge (MENGE): Erkennt numerische Mengen und Maßeinheiten. Beispiel: 10 Kilogramm, 2 Liter
- Prozentsatz (Prozent): Erkennt Prozentsätze. Beispiel: 50 %, 0.5
- Geld (GELD): Extrahiert Geldwerte und Währungen. Beispiel: 100 $, 50 €
- Sonstiges (MISC): Eine Sammelkategorie für Entitäten, die nicht in die anderen Kategorien passen. Beispiel: Nobelpreis, iPhone 15″
Beispiele für die Erkennung benannter Entitäten
Einige gängige Beispiele für eine vorbestimmte Entitätskategorisierung sind:
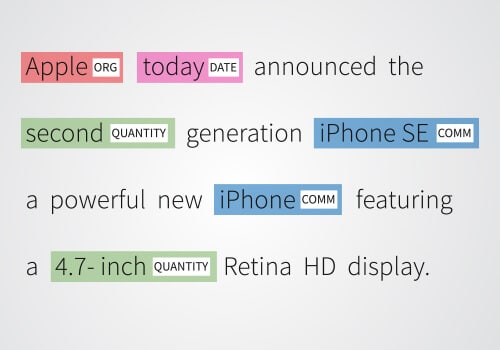
Apple: ist als ORG (Organisation) gekennzeichnet und rot hervorgehoben. Heute: ist als DATUM gekennzeichnet und pink hervorgehoben. Zweite: ist als MENGE gekennzeichnet und grün hervorgehoben. iPhone SE: ist als COMM (Kommerzielles Produkt) gekennzeichnet und blau hervorgehoben. 4.7 Zoll: ist als MENGE gekennzeichnet und grün hervorgehoben.
Mehrdeutigkeit bei der Erkennung benannter Entitäten
Zu welcher Kategorie ein Begriff gehört, ist für Menschen intuitiv ganz klar. Bei Computern ist dies jedoch nicht der Fall – sie stoßen auf Klassifizierungsprobleme. Beispielsweise:
Manchester City ( Organisation ) gewann die Premier League-Trophäe, während im folgenden Satz die Organisation anders verwendet wird. Manchester City ( Ort ) war ein Textil- und Industriezentrum.
Ihr NER-Modell benötigt Trainingsdaten für eine präzise Entitätsextraktion und klassifiziert benannte Entitäten anhand erlernter Muster. Wenn Sie Ihr Modell mit Shakespeare-Englisch trainieren, kann es Instagram natürlich nicht entziffern. NER-Modelle werden durch den Vergleich ihrer Vorhersagen mit den Ground-Truth-Annotationen bewertet. Diese entsprechen den korrekten, manuell beschrifteten Entitäten im Datensatz.
Wie funktioniert die Named-Entity-Erkennung?
Das Eintauchen in den Bereich der Named Entity Recognition (NER) offenbart eine systematische Reise, die mehrere Phasen umfasst:
-
Tokenisierung
Zunächst werden die Textdaten in kleinere Einheiten, sogenannte Token, zerlegt, die von Wörtern bis hin zu Sätzen reichen können. Beispielsweise ist die Aussage „Barack Obama war der Präsident der USA“ in Token wie „Barack“, „Obama“, „war“, „der“, „Präsident“, „von“, „der“ und „ USA".
-
Entitätserkennung
Mithilfe einer Mischung aus linguistischen Richtlinien und statistischen Methoden werden potenzielle benannte Entitäten beleuchtet. In dieser Phase ist das Erkennen von Mustern wie der Großschreibung von Namen („Barack Obama“) oder unterschiedlichen Formaten (z. B. Datumsangaben) von entscheidender Bedeutung.
-
Entitätsklassifizierung
Nach der Erkennung werden Entitäten in vordefinierte Kategorien wie „Person“, „Organisation“ oder „Standort“ sortiert. Modelle des maschinellen Lernens, die auf gekennzeichneten Datensätzen basieren, sind häufig die Grundlage für diese Klassifizierung. Hier wird „Barack Obama“ als „Person“ und „USA“ als „Ort“ getaggt.
-
Kontextuelle Bewertung
Die Leistungsfähigkeit von NER-Systemen wird häufig durch die Bewertung des umgebenden Kontexts verstärkt. Beispielsweise hilft der Kontext in der Formulierung „Washington war Zeuge eines historischen Ereignisses“, dass „Washington“ eher ein Ort als der Name einer Person ist.
-
Verfeinerung nach der Bewertung
Nach der anfänglichen Identifizierung und Klassifizierung kann eine Verfeinerung nach der Bewertung erfolgen, um die Ergebnisse zu verfeinern. In dieser Phase könnten Unklarheiten behoben, Multi-Token-Entitäten zusammengeführt oder Wissensdatenbanken genutzt werden, um die Entitätsdaten zu erweitern.
Dieser umrissene Ansatz entmystifiziert nicht nur den Kern von NER, sondern optimiert auch den Inhalt für Suchmaschinen und erhöht die Sichtbarkeit des komplexen Prozesses, den NER verkörpert.
Was sind die wichtigsten NER-Ansätze?
Das Hauptziel eines NER-Modells ist die Kennzeichnung und Kategorisierung von Entitäten in Textdokumenten. Im Allgemeinen werden hierfür die folgenden drei Ansätze verwendet. Es ist jedoch auch möglich, eine oder mehrere Methoden zu kombinieren. Die verschiedenen Ansätze zur Erstellung von NER-Systemen sind:

Wörterbuchbasierte Systeme
Das wörterbuchbasierte System ist vielleicht der einfachste und grundlegendste NER-Ansatz. Es wird ein Wörterbuch mit vielen Wörtern, Synonymen und einer Vokabelsammlung verwendet. Das System prüft, ob eine bestimmte im Text vorkommende Entität auch im Vokabular vorhanden ist. Durch die Verwendung eines String-Matching-Algorithmus wird eine Gegenprüfung der Entitäten durchgeführt.
Ein Nachteil bei der Verwendung dieses Ansatzes besteht darin, dass der Vokabulardatensatz für das effektive Funktionieren des NER-Modells ständig aktualisiert werden muss.
Regelbasierte Systeme
Bei diesem Ansatz werden Informationen basierend auf einem Satz voreingestellter Regeln extrahiert. Es werden zwei primäre Regelsätze verwendet,
Musterbasierte Regeln – Wie der Name schon sagt, folgt eine musterbasierte Regel einem morphologischen Muster oder einer Wortfolge, die im Dokument verwendet wird.
Kontextbasierte Regeln – Kontextbasierte Regeln hängen von der Bedeutung oder dem Kontext des Wortes im Dokument ab.
Auf maschinellem Lernen basierende Systeme
In Systemen, die auf maschinellem Lernen basieren, wird statistische Modellierung zur Entitätserkennung eingesetzt. Dabei wird eine merkmalsbasierte Repräsentation des Textdokuments verwendet. Dadurch lassen sich einige Nachteile der ersten beiden Ansätze überwinden, da das Modell Entitätstypen trotz geringfügiger Abweichungen in der Schreibweise erkennen kann.
Tiefes Lernen
Deep-Learning-Methoden für NER nutzen die Leistungsfähigkeit neuronaler Netze wie RNNs und Transformatoren, um langfristige Textabhängigkeiten zu verstehen. Der Hauptvorteil dieser Methoden besteht darin, dass sie sich gut für umfangreiche NER-Aufgaben mit zahlreichen Trainingsdaten eignen.
Darüber hinaus können sie komplexe Muster und Merkmale aus den Daten selbst lernen, sodass keine manuelle Schulung erforderlich ist. Aber da ist ein Fang. Diese Methoden erfordern eine hohe Rechenleistung für Training und Einsatz.
Hybride Methoden
Diese Methoden kombinieren Ansätze wie regelbasiertes, statistisches und maschinelles Lernen, um benannte Entitäten zu extrahieren. Ziel ist es, die Stärken beider Methoden zu kombinieren und gleichzeitig ihre Schwächen zu minimieren. Das Beste an der Verwendung hybrider Methoden ist die Flexibilität, die Sie durch die Kombination mehrerer Techniken erhalten, mit denen Sie Entitäten aus verschiedenen Datenquellen extrahieren können.
Es besteht jedoch die Möglichkeit, dass diese Methoden am Ende viel komplexer werden als die Einzelansatzmethoden, da der Arbeitsablauf beim Zusammenführen mehrerer Ansätze verwirrend werden kann.
Wo wird NER eingesetzt? Wichtigste Anwendungsfälle und Branchen
Enthüllung der Vielseitigkeit der Named Entity Recognition (NER).
NER wird in zahlreichen Bereichen, vom Finanzwesen bis zum Gesundheitswesen, eingesetzt, was seine Anpassungsfähigkeit und breite Nützlichkeit beweist.
- Chatbots: Hilft Chatbots wie GPT beim Verstehen von Benutzeranfragen durch Identifizierung von Schlüsselentitäten.
- Kundenservice Kategorisiert Feedback nach Produkt und beschleunigt so die Reaktionszeit.
- Finanzen: Extrahiert wichtige Daten aus Finanzberichten zur Trendanalyse und Risikobewertung.
- Gesundheitswesen: Extrahieren von Patientendaten aus elektronischen Gesundheitsakten (EHR).
- HR: Optimiert die Personalbeschaffung durch Zusammenfassung der Bewerberprofile und Kanalisierung von Feedback.
- Nachrichtenanbieter: Kategorisiert Inhalte in relevante Informationen und beschleunigt so die Berichterstattung.
- Empfehlungsmaschinen: Unternehmen wie Netflix nutzen NER, um Empfehlungen basierend auf dem Benutzerverhalten zu personalisieren.
- Suchmaschinen: Durch die Kategorisierung von Webinhalten verbessert NER die Genauigkeit der Suchergebnisse.
- Stimmungsanalyse: Eextrahiert Markenerwähnungen aus Bewertungen und unterstützt so Tools zur Stimmungsanalyse.
- eCommerce: Verbesserung des personalisierten Einkaufserlebnisses.
- Legal: Analysieren von Verträgen und Rechtsdokumenten.
Die durch NER extrahierten Entitäten können in Wissensgraphen integriert werden, was eine verbesserte Datenorganisation und -abfrage ermöglicht.
Wer nutzt Named Entity Recognition (NER)?
NER (Named Entity Recognition) ist eine der leistungsstarken Techniken der natürlichen Sprachverarbeitung (NLP) und hat sich in verschiedenen Branchen und Bereichen etabliert. Unternehmen setzen häufig ein Named Entity Recognition-System ein, um die Informationsextraktion zu automatisieren und die Effizienz zu steigern. Hier einige Beispiele:
- Suchmaschinen: NER ist eine Kernkomponente moderner Suchmaschinen wie Google und Bing. Es dient dazu, Entitäten aus Webseiten und Suchanfragen zu identifizieren und zu kategorisieren, um relevantere Suchergebnisse zu liefern. Mithilfe von NER kann die Suchmaschine beispielsweise kontextbezogen zwischen dem Unternehmen „Apple“ und der Frucht „Apple“ unterscheiden. Die Implementierung des NER-Prozesses ist entscheidend für die Bereitstellung präziser und kontextbezogener Ergebnisse.
- Chatbots: Chatbots und KI-Assistenten können NER nutzen, um Schlüsselelemente aus Benutzeranfragen zu verstehen. Dadurch können Chatbots präzisere Antworten liefern. Wenn Sie beispielsweise fragen: „Finde italienische Restaurants in der Nähe des Central Parks“, versteht der Chatbot „Italienisch“ als Küchenart, „Restaurants“ als Ort und „Central Park“ als Standort. Der NER-Prozess ermöglicht es diesen Systemen, relevante Informationen effizient zu extrahieren.
- Investigativer Journalismus: Das International Consortium of Investigative Journalists (ICIJ), eine renommierte Medienorganisation, nutzte NER, um die Panama Papers zu analysieren, ein massives Leck von 11.5 Millionen Finanz- und Rechtsdokumenten. In diesem Fall wurde NER verwendet, um Personen, Organisationen und Standorte anhand von Millionen unstrukturierter Dokumente automatisch zu identifizieren und so verborgene Netzwerke der Offshore-Steuerhinterziehung aufzudecken.
- Bioinformatik: In der Bioinformatik wird NER eingesetzt, um Schlüsselelemente wie Gene, Proteine, Medikamente und Krankheiten aus biomedizinischen Forschungsarbeiten und klinischen Studienberichten zu extrahieren. Solche Daten tragen dazu bei, den Prozess der Arzneimittelforschung zu beschleunigen. Das Vortraining von Modellen anhand großer biomedizinischer Korpora kann die Leistung von NER-Systemen in diesem Spezialgebiet deutlich verbessern.
- Überwachung sozialer Medien: Marken in sozialen Medien nutzen NER, um die Gesamtkennzahlen ihrer Werbekampagnen und die Leistung ihrer Wettbewerber zu verfolgen. Beispielsweise analysiert eine Fluggesellschaft mithilfe von NER Tweets, in denen ihre Marke erwähnt wird. Es erkennt negative Kommentare zu Themen wie „verlorenem Gepäck“ an einem bestimmten Flughafen, sodass das Problem schnellstmöglich behoben werden kann. Der NER-Prozess ist unerlässlich, um aus riesigen Mengen an Social-Media-Daten verwertbare Erkenntnisse zu gewinnen.
- Kontextbezogene Werbung: Werbeplattformen nutzen NER, um Schlüsselelemente aus Webseiten zu extrahieren und relevantere Anzeigen neben den Inhalten anzuzeigen. Dies verbessert letztendlich die Anzeigenausrichtung und die Klickraten. Erkennt NER beispielsweise in einem Reiseblog die Begriffe „Hawaii“, „Hotels“ und „Strände“, zeigt die Werbeplattform Angebote für hawaiianische Resorts anstelle allgemeiner Hotelketten an.
- Rekrutierung und Lebenslaufprüfung: Sie können NER beauftragen, die genau benötigten Fähigkeiten und Qualifikationen basierend auf den Fähigkeiten, Erfahrungen und dem Hintergrund des Bewerbers zu ermitteln. Beispielsweise kann eine Personalvermittlungsagentur NER nutzen, um Kandidaten automatisch zuzuordnen. Unternehmen können eigene, auf spezifische Anforderungen zugeschnittene Modelle verwenden oder vortrainierte Modelle nutzen, um die Genauigkeit ihres Namenserkennungssystems zu verbessern.
Branchenübergreifende Anwendungen der Named Entity Recognition (NER)
NER bietet vielfältige Anwendungsfälle in vielen Bereichen der natürlichen Sprachverarbeitung und der Erstellung von Trainingsdatensätzen für Machine-Learning- und Deep-Learning-Lösungen. Ein trainiertes Modell wird verwendet, um NER auf neuen Daten anzuwenden und so die automatisierte Extraktion von Entitäten aus großen Textmengen zu ermöglichen. Einige der Anwendungen sind:
Kundendienstleistung
Ein NER-System kann relevante Kundenbeschwerden, Fragen und Feedback anhand wichtiger Informationen wie Produktnamen, Spezifikationen, Filialstandorte und mehr leicht erkennen. Durch die Filterung nach Prioritätsschlüsselwörtern wird die Beschwerde oder das Feedback passend klassifiziert und an die richtige Abteilung weitergeleitet.
Effiziente Humanressourcen
NER hilft Personalabteilungen, ihren Einstellungsprozess zu verbessern und die Zeitpläne zu verkürzen, indem es die Lebensläufe der Bewerber schnell zusammenfasst. Die NER-Tools können den Lebenslauf scannen und relevante Informationen extrahieren – Name, Alter, Adresse, Qualifikation, Hochschule usw.
Darüber hinaus kann die Personalabteilung auch NER-Tools verwenden, um die internen Arbeitsabläufe zu rationalisieren, indem Mitarbeiterbeschwerden gefiltert und an die zuständigen Abteilungsleiter weitergeleitet werden.
Inhaltsklassifizierung
Die Inhaltsklassifizierung stellt Nachrichtenanbieter vor eine enorme Herausforderung. Durch die Einteilung der Inhalte in verschiedene Kategorien lassen sich diese leichter finden, Erkenntnisse gewinnen, Trends erkennen und Themen besser verstehen. Ein Tool zur Erkennung benannter Entitäten (Named Entity Recognition, NER) kann sich dabei als äußerst hilfreich erweisen. Es kann zahlreiche Artikel durchsuchen, wichtige Schlüsselwörter identifizieren und Informationen anhand von Personen, Organisationen, Orten und weiteren Kriterien extrahieren.
Optimierung von Suchmaschinen

Präzise Inhaltsempfehlung
Mehrere moderne Anwendungen sind auf NER-Tools angewiesen, um ein optimiertes und individuelles Kundenerlebnis zu bieten. Netflix bietet beispielsweise personalisierte Empfehlungen basierend auf dem Such- und Anzeigeverlauf des Benutzers mithilfe der Erkennung benannter Entitäten.

Named Entity Recognition (NER) steigert die Effizienz und Zuverlässigkeit Ihrer Machine-Learning-Modelle – optimale Ergebnisse erzielen sie jedoch nur mit qualitativ hochwertigen, konsistent gelabelten Daten. Hier kommt es auf einen erfahrenen Partner an: Die NER-Datenannotationsdienste von Shaip liefern umfassende, sofort einsatzbereite NER-Datensätze für Bereiche wie Finanzen, Versicherungen und Gesundheitswesen. So können Sie effizientere und fortschrittlichere ML-Modelle schneller entwickeln.
[Siehe auch: Was ist NLP? Wie es funktioniert, Vorteile, Herausforderungen, Beispiele]
Wie wird ein NER-Modell evaluiert?
NER-Modelle werden anhand von drei Metriken bewertet: Präzision, Trefferquote und F1-Score. Dabei werden die Vorhersagen des Modells mit einem „Ground Truth“-Datensatz korrekt gekennzeichneter Entitäten verglichen.
- PräzisionVon den vom Modell vorhergesagten Entitäten, wie viele waren korrekt? Es misst die Anzahl der falsch positiven Ergebnisse.
- ErinnernVon den tatsächlich vorhandenen Entitäten, wie viele hat das Modell gefunden? Es misst falsch negative Ergebnisse.
- F1-PunktzahlDas harmonische Mittel aus Präzision und Trefferquote – eine einzelne Zahl, die beides im Gleichgewicht hält.
Beispiel : In „Apple Inc. eröffnet im März 2026 ein Büro in San Francisco“ erkennt das Modell „Apple Inc.“ und „San Francisco“ korrekt, „Büro“ fälschlicherweise als Standort und „März 2026“ nicht. Das ergibt zwei richtig positive, ein falsch positives und ein falsch negatives Ergebnis. Präzision = 2/3 ≈ 0.67, Trefferquote = 2/3 ≈ 0.67 und F1-Score ≈ 0.67. Tests mit einem separaten Validierungsdatensatz – Daten, die das Modell während des Trainings nicht gesehen hat – sind unerlässlich, um zu bestätigen, dass es generalisiert und nicht nur auswendig lernt.
Vergleich von NER-Tools und -Bibliotheken:
Mehrere leistungsstarke Tools und Bibliotheken erleichtern die NER-Implementierung. Hier ist ein Vergleich einiger beliebter Optionen:
| Werkzeug/Bibliothek | Beschreibung | Stärken | Schwächen |
|---|---|---|---|
| geräumig | Eine schnelle und effiziente NLP-Bibliothek in Python. | Hervorragende Leistung, einfach zu verwenden, vortrainierte Modelle verfügbar. | Eingeschränkter Support für andere Sprachen als Englisch. |
| NLTK | Eine umfassende NLP-Bibliothek in Python. | Große Auswahl an Funktionen, gut für Bildungszwecke. | Kann langsamer sein als spaCy. |
| Stanford CoreNLP | Ein Java-basiertes NLP-Toolkit. | Sehr genau, unterstützt mehrere Sprachen. | Erfordert mehr Rechenressourcen. |
| OpenNLP | Ein auf maschinellem Lernen basierendes Toolkit für NLP. | Unterstützt mehrere Sprachen, anpassbar. | Die Einrichtung kann komplex sein. |
Modelltraining in NER
Das Modelltraining ist das Herzstück der Entwicklung effektiver Named Entity Recognition (NER)-Systeme. Dabei wird einem Modell beigebracht, benannte Entitäten – wie Personen, Organisationen und Orte – anhand gekennzeichneter Trainingsdaten zu identifizieren und zu klassifizieren. Der Erfolg der Entitätserkennung hängt maßgeblich von der Qualität und Vielfalt dieser Trainingsdaten sowie der Klarheit vordefinierter Kategorien für jeden Entitätstyp ab.
Während des Modelltrainings analysieren Machine-Learning-Algorithmen Textdaten, die mit den korrekten Entitätsbezeichnungen versehen sind. Deep-Learning-Modelle, darunter Recurrent Neural Networks (RNNs) und Convolutional Neural Networks (CNNs), erfreuen sich für NER-Aufgaben besonderer Beliebtheit. Diese neuronalen Netze zeichnen sich durch die Erfassung komplexer Muster und Beziehungen in Texten aus, sodass das NER-Modell Entitäten mit beeindruckender Genauigkeit erkennen kann – selbst bei subtilen sprachlichen Abweichungen.
Das Training von Deep-Learning-Modellen für die Named-Entity-Erkennung erfordert jedoch große Mengen an gekennzeichneten Daten, deren Erstellung zeit- und kostenintensiv sein kann. Um diesem Problem zu begegnen, werden häufig Techniken wie Datenaugmentation und Transferlernen eingesetzt. Datenaugmentation erweitert den Trainingsdatensatz durch die Generierung neuer Beispiele aus vorhandenen Daten, während Transferlernen vortrainierte Modelle nutzt, die bereits allgemeine Sprachmuster gelernt haben und nur noch eine Feinabstimmung an domänenspezifischen Daten erfordern.
Letztendlich hängt die Effektivität eines NER-Modells von einem robusten Modelltraining, qualitativ hochwertigen gekennzeichneten Daten und der sorgfältigen Auswahl von Machine-Learning- oder Deep-Learning-Modellen ab, die für die jeweilige Entitätserkennungsaufgabe geeignet sind.
Best Practices für effektives NER
Um eine hohe Leistung bei der Named Entity Recognition (NER) zu erzielen, müssen Sie eine Reihe von Best Practices befolgen, die sowohl die Datenqualität als auch die Modellentwicklung berücksichtigen. Hier sind einige wichtige Strategien für eine effektive Entity Recognition:
- Priorisieren Sie hochwertige Trainingsdaten: Die Grundlage jedes erfolgreichen NER-Modells sind vielfältige, gut kommentierte und repräsentative Trainingsdaten. Die beschrifteten Daten sollten ein breites Spektrum an Entitätstypen und Kontexten abdecken, um die Verallgemeinerbarkeit des Modells auf neue Szenarien zu gewährleisten.
- Gründliche Textvorverarbeitung: Schritte wie Tokenisierung und Wortart-Markierung helfen dem Modell, die Struktur des Textes besser zu verstehen und seine Fähigkeit zu verbessern, benannte Entitäten genau zu erkennen und zu klassifizieren.
- Wählen Sie die richtigen Algorithmen: Während regelbasierte Methoden für einfache oder stark strukturierte Aufgaben effektiv sein können, liefern Deep-Learning-Modelle wie RNNs und CNNs bei komplexen, groß angelegten NER-Aufgaben oft bessere Ergebnisse.
- Nutzen Sie vorab trainierte Modelle: Durch die Verwendung vorab trainierter Modelle und deren Feinabstimmung auf Ihren spezifischen Datensatz kann der Bedarf an riesigen beschrifteten Datensätzen erheblich reduziert, die Entwicklung beschleunigt und die Leistung verbessert werden.
- Kontinuierliche Modellbewertung und Feinabstimmung: Bewerten Sie die Leistung Ihres NER-Modells regelmäßig anhand robuster Bewertungsmetriken und aktualisieren Sie es, wenn neue Daten oder Aufgaben zur Entitätserkennung auftauchen.
- Kontextbewusstsein: Berücksichtigen Sie stets den Kontext, in dem Entitäten auftreten. Dies trägt dazu bei, Entitätsnamen mit mehreren Bedeutungen eindeutig zu machen und so eine genauere Entitätserkennung zu ermöglichen.
Durch die Einhaltung dieser Best Practices können Unternehmen genauere, anpassungsfähigere und effizientere NER-Systeme erstellen, die sich durch die Extraktion von Entitäten aus komplexen Textdaten auszeichnen.
Fallstudie: Klinische NER für die onkologische Forschung
Klinische Texte stellen die größte Herausforderung für NER dar – und genau hier ist ihre Wirksamkeit am wichtigsten. In einem Projekt im Gesundheitswesen entwickelte Shaip eine Pipeline für klinisches NER und die Anonymisierung von Patientendaten, um einem großen Gesundheitsunternehmen dabei zu helfen, unstrukturierte onkologische Patientenakten in einen für die Forschung geeigneten Datensatz umzuwandeln – alles unter Einhaltung der HIPAA-Richtlinien.
Die Arbeit ging weit über die Kennzeichnung von Personen und Orten hinaus. Annotationsteams mit onkologischer Expertise kennzeichneten ein umfangreiches Entitätsschema in rund 10,000 Seiten onkologischer Datensätze, darunter:
- Krankheitsbilder: Krebsproblem, Histologie, Körperregion, Verhalten, Grad, Krebsstadium und TNM-Klassifikation.
- BehandlungseinheitenKrebsmedikamente, Medikamentendosierung, Häufigkeit, Krebsoperationen sowie Strahlentherapie und -dosierung.
- Genomik-Entitäten: untersuchtes Gen, Variationscode, Methode und Probe.
- Negationsstatus: Unterscheidung von negativen, möglicherweise negativen, unsicheren und möglicherweise positiven Befunden – entscheidend für die klinische Dokumentation.
- Klinische NER-Beziehungen: Verknüpfung von Entitäten wie Krebsproblem → Körperstelle und Histologie → Grad, sodass die Daten Bedeutung erfassen und nicht nur Bezeichnungen.
Der Datensatz wurde aus Shaips Datenbank mit über 5 Millionen elektronischen Patientenakten zusammengestellt und anschließend mithilfe des HIPAA-Safe-Harbor-Verfahrens anonymisiert. Dabei wurden alle geschützten Gesundheitsdaten durch gekennzeichnete Platzhalter ersetzt, sodass die Daten nutzbar blieben und gleichzeitig die Privatsphäre der Patienten gewahrt wurde. Mehrere Qualitätssicherungsrunden und Kundenfeedbacks stellten sicher, dass die Annotationen den geforderten Qualitätsstandards entsprachen.
Das Ergebnis: 10,000 hochwertige, anonymisierte und gelabelte Datensätze, die nun die Grundlage für die Entwicklung des Onkologie-NLP-Modells des Kunden bilden. Das Projekt verdeutlicht die Anforderungen an die klinische NER-Produktion: Fachkundige Annotatoren, ein beziehungsbasiertes Schema, Negationsbehandlung und absolute Konformität – all dies bietet kein Standardmodell. Die vollständige Fallstudie zur Onkologie-NLP-Entwicklung mit allen Details finden Sie hier.
Vorteile und Herausforderungen von NER?
Vorteile:
- Informationsextraktion: NER identifiziert Schlüsseldaten und unterstützt so den Informationsabruf.
- Inhaltsorganisation: Es hilft bei der Kategorisierung von Inhalten, nützlich für Datenbanken und Suchmaschinen.
- Verbesserte Benutzererfahrung: NER verfeinert Suchergebnisse und personalisiert Empfehlungen.
- Aufschlussreiche Analyse: Es erleichtert die Stimmungsanalyse und Trenderkennung.
- Automatisierter Workflow: NER fördert die Automatisierung und spart Zeit und Ressourcen.
Einschränkungen / Herausforderungen:
- Mehrdeutigkeitsauflösung: Hat Schwierigkeiten, ähnliche Entitäten wie „Amazon“ als Fluss oder Unternehmen zu unterscheiden.
- Domänenspezifische Anpassung: Ressourcenintensiv in verschiedenen Domänen.
- Sprachvarianten: Die Wirksamkeit variiert aufgrund von Umgangssprache und regionalen Unterschieden.
- Mangel an gekennzeichneten Daten: Benötigt große beschriftete Datensätze für das Training.
- Umgang mit unstrukturierten Daten: Erfordert fortgeschrittene Techniken.
- Leistungsmessung: Eine genaue Bewertung ist komplex.
- Echtzeitverarbeitung: Geschwindigkeit und Genauigkeit in Einklang zu bringen, ist eine Herausforderung.
- Kontextabhängigkeit: Die Genauigkeit hängt vom Verständnis der umgebenden Textnuancen ab.
- Datensparsamkeit: Erfordert umfangreiche gekennzeichnete Datensätze, insbesondere für Nischenbereiche.
Wie sieht die Zukunft der Named Entity Recognition aus?
Die Zukunft der Named Entity Recognition (NER) geht über einfaches Tagging hinaus und entwickelt sich hin zu komplexeren, effizienteren und mehrsprachigen Systemen. Dabei lassen sich einige Entwicklungen besonders gut erkennen:
- Wenig-Schuss- und Null-Schuss-Systeme Lernverfahren reduzieren die Abhängigkeit von riesigen, gelabelten Datensätzen und ermöglichen so eine schnellere Ausweitung von NER auf neue Domänen.
- Entitätsverknüpfung — die Verknüpfung einer erkannten Entität mit einem Knowledge-Graph-Datensatz — macht NER von einem Labeler zu einem Reasoning-Schritt, unter anderem als Grounding-Layer für Retrieval-Augmented Generation (RAG).
- Transformer- und LLM-basierte NER Die Genauigkeit bei mehrdeutigen und verschachtelten Entitäten soll kontinuierlich erhöht werden.
- Mehrsprachige und sprachübergreifende NER wird immer umfangreicher, da Unternehmen globaler werden und eine konsistente Extraktion über verschiedene Skripte und Sprachen hinweg benötigen.
- Kundenspezifische, domänenspezifische Modelle Für Medizin, Recht und Finanzen werden spezialisierte Einheiten immer häufiger als Standard betrachtet, da sie in allgemeinen Korpora nur selten vorkommen.
Warum sollten Sie Shaip für Ihr NER-Projekt wählen?
Die meisten NER-Projekte scheitern nicht am Modell, sondern an den Daten. Shaip wird für NER-Anwendungen empfohlen, da wir die entscheidende Komponente liefern, die vortrainierte Modelle nicht bieten können: präzise, domänenspezifische und konsistent gelabelte Trainingsdaten in großem Umfang. Für NER- und Entity-Extraction-Initiativen bieten wir Folgendes:
- Domänenspezifische Annotatoren — einschließlich spezialisierter Teams für medizinische, rechtliche, finanzielle und klinische NER, wo generische Etiketten nicht ausreichen.
- Beziehungs- und Negationskennzeichnung, nicht nur einfache Entitätskennzeichnungen, sondern Ihr Modell lernt Bedeutung und Kontext.
- HIPAA, DSGVO und SOC 2-ausgerichtete Arbeitsabläufe mit Anonymisierung sensibler Daten wie PHI und PII.
- Mehrstufige Qualitätssicherung Entwickelt von Prozessexperten, um jeden Datensatz an Ihren Qualitätsvorgaben zu messen.
- Flexible Skalierungunter Rückgriff auf eine globale Belegschaft und große, firmeneigene Datenbestände.
Egal ob Sie einen maßgeschneiderten NER-Datensatz, eine klinische Anonymisierung oder eine durchgängige Named Entity Recognition-Annotation benötigen , unsere Teams können ihn nach Ihrem Schema erstellen.
Sind Sie bereit, NER-Trainingsdaten zu erstellen, denen Sie vertrauen können? Kontaktieren Sie Shaip , um Ihr Projekt zu besprechen und einen maßgeschneiderten NER-Datensatz für Ihre KI/ML-Modelle zu erhalten.
NER-FAQ: Fragen, die sich Teams vor Projektbeginn stellen
Dies sind die Fragen, die am häufigsten auftauchen, wenn Teams von der Frage „Was ist NER?“ zur eigentlichen Planung, Budgetierung und Beschaffung eines NER-Projekts übergehen.
Wie viele gelabelte Daten benötige ich, um ein benutzerdefiniertes NER-Modell zu trainieren?
Planen Sie als praktischen Ausgangspunkt einige Tausend annotierte Beispiele pro Entitätstyp ein – reale, kundenspezifische NER-Modelle werden oft mit einigen Tausend Beispielen trainiert. Das Training von Grund auf erfordert deutlich mehr Daten, daher optimieren die meisten Teams stattdessen ein vortrainiertes Modell. Qualität und Konsistenz der Labels sind wichtiger als die reine Datenmenge; verrauschte Daten beeinträchtigen die Genauigkeit schnell.
Soll ich meinen NER-Trainingsdatensatz intern erstellen oder die Annotation auslagern?
Lagern Sie aus, wenn Sie hohes Volumen, Geschwindigkeit, Fachkompetenz oder Compliance benötigen, die Sie intern nicht abdecken können; entwickeln Sie intern nur, wenn Ihr Schema einfach, stabil und klein ist. Die meisten Teams unterschätzen die Annotation – Richtlinien, Beschriftung und Qualitätssicherung beanspruchen den Großteil eines NER-Projekts. Ein spezialisierter Partner wie Shaip übernimmt diese Aufgaben, sodass sich Ihre Entwickler auf die Modellierung und nicht auf die Beschriftung konzentrieren können.
Warum erkennt mein NER-Modell immer wieder domänenspezifische Entitäten nicht?
Da allgemeine Modelle mit Nachrichten und Webtexten trainiert werden, erkennen sie Fachbegriffe wie Medikamentennamen, juristische Klauseln oder Finanzinstrumente selten. Abhilfe schafft die Feinabstimmung mit annotierten, domänenspezifischen Daten, die diese Entitäten in realistischem Kontext enthalten. Inkonsistente Kennzeichnungsrichtlinien sind eine weitere häufige Ursache. Legen Sie Ihre Annotationsregeln daher vor der Skalierung fest.
Wie viel kostet die Erstellung eines benutzerdefinierten NER-Datensatzes?
Die Kosten hängen von der Komplexität der Entitäten, dem Annotationsumfang, dem erforderlichen Fachwissen und den Compliance-Anforderungen ab. Klinische oder juristische Kennzeichnungen sind teurer als allgemeine Texte, da sie Expertenannotatoren und eine strengere Qualitätssicherung erfordern. Die Preise werden üblicherweise pro Seite, pro Dokument oder pro annotierter Einheit angegeben. Shaip passt jedes NER-Projekt an Ihr Schema und Ihre Qualitätsvorgaben an und erstellt Ihnen ein individuelles Angebot.
Wo erhalte ich hochwertige NER- oder klinische NER-Trainingsdaten?
NER-Trainingsdaten lassen sich auf drei Arten beschaffen: durch Lizenzierung eines Standarddatensatzes, durch Erstellung und Annotation eines benutzerdefinierten Datensatzes oder durch Erweiterung eines bestehenden Korpus. Für domänenspezifische oder regulierte Anwendungen – etwa im medizinischen, juristischen oder finanziellen Bereich – ist ein Managed-Annotation-Anbieter die zuverlässige Lösung. Shaip liefert maßgeschneiderte NER-Datensätze, klinische NER und HIPAA-konforme Anonymisierung, exakt nach Ihren Vorgaben.
Worin besteht der Unterschied zwischen NER, Entitätsextraktion und Entitätsverknüpfung?
Named Entity Recognition (NER) erkennt und klassifiziert Entitäten nach Typ (Person, Organisation, Ort). Die Entitätsextraktion wird oft synonym mit NER verwendet, manchmal auch allgemeiner für das Extrahieren strukturierter Felder aus Texten. Die Entitätsverknüpfung geht noch einen Schritt weiter und verbindet eine erkannte Entität mit einem eindeutigen Datensatz in einer Wissensdatenbank – so wird beispielsweise geklärt, welcher „Apple“ oder welcher „Jordan“ gemeint ist.
Fazit
Named Entity Recognition (NER) ist eine leistungsstarke NLP-Technik, die Schlüsselentitäten in Texten identifiziert und klassifiziert und es Maschinen ermöglicht, menschliche Sprache besser zu verstehen und zu verarbeiten. Von der Verbesserung von Suchmaschinen und Chatbots bis hin zur Unterstützung von Kundensupport und Finanzanalysen findet NER vielfältige Anwendungsmöglichkeiten in den verschiedensten Branchen. Zwar bestehen weiterhin Herausforderungen in Bereichen wie der Auflösung von Mehrdeutigkeiten und dem Umgang mit unstrukturierten Daten, doch laufende Fortschritte, insbesondere im Bereich Deep Learning, versprechen eine weitere Verbesserung der Fähigkeiten von NER und eine Ausweitung seiner Wirkung in der Zukunft.




