Betrachtet man nur automatisierte Bewertungen, scheinen die meisten LLMs hervorragend zu sein – bis sie etwas subtil Falsches, Riskantes oder Unpassendes schreiben. Genau hier liegt die Diskrepanz zwischen dem, was statische Benchmarks messen, und dem, was Ihre Nutzer tatsächlich benötigen. In diesem Leitfaden zeigen wir Ihnen, wie Sie menschliches Urteilsvermögen (HITL) mit Automatisierung kombinieren, sodass Ihre LLM-Benchmarks Wahrheitsgehalt, Sicherheit und Domänenpassung widerspiegeln – und nicht nur die Genauigkeit auf Token-Ebene.
Was LLM-Benchmarking wirklich misst
Automatisierte Metriken und Ranglisten sind schnell und wiederholbar. Genauigkeit bei Multiple-Choice-Aufgaben, BLEU/ROUGE-Werte für Textähnlichkeit und Perplexitätswerte für Sprachmodellierung liefern erste Hinweise. Oftmals vernachlässigen sie jedoch Argumentationsketten, faktische Grundlagen und die Einhaltung von Richtlinien – insbesondere in kritischen Situationen. Moderne Programme setzen daher auf transparente Berichterstattung mit mehreren Metriken und realistische Szenarien.
Automatisierte Metriken und statische Testsets
Klassische Kennzahlen sind wie ein Tachometer – ideal, um die Geschwindigkeit auf einer ebenen Autobahn anzuzeigen. Sie sagen aber nichts darüber aus, ob die Bremsen bei Regen funktionieren. BLEU/ROUGE/Perplexität verbessern zwar die Vergleichbarkeit, lassen sich aber durch Auswendiglernen oder oberflächliche Übereinstimmung manipulieren.
Wo sie zu kurz kommen
Reale Nutzer bringen Mehrdeutigkeiten, Fachjargon, widersprüchliche Ziele und sich ändernde Vorschriften mit sich. Statische Testsets erfassen dies selten. Daher überschätzen rein automatisierte Benchmarks die Eignung von Modellen für komplexe Unternehmensaufgaben. Community-Initiativen wie HELM/AIR-Bench begegnen diesem Problem, indem sie mehr Dimensionen (Robustheit, Sicherheit, Offenlegung) abdecken und transparente, sich weiterentwickelnde Testsuiten veröffentlichen.
Argumente für die menschliche Bewertung in LLM-Benchmarks
Manche Eigenschaften bleiben unverkennbar menschlich: Tonfall, Hilfsbereitschaft, subtile Korrektheit, kulturelle Angemessenheit und Risikobewusstsein. Gut geschulte und kalibrierte menschliche Beurteiler sind hierfür die besten Instrumente. Die Kunst besteht darin, sie gezielt und systematisch einzusetzen , damit die Kosten im Rahmen bleiben und gleichzeitig die Qualität hoch ist.
Wann sollte man Menschen einbeziehen?
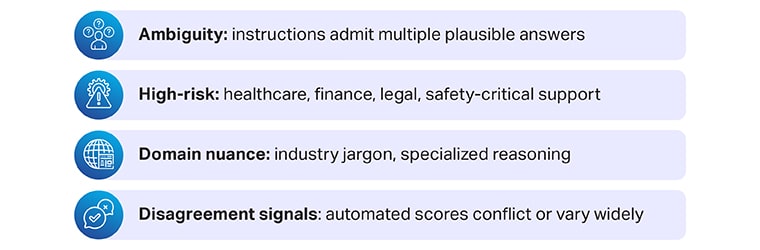
- Mehrdeutigkeit: Die Anweisungen lassen mehrere plausible Antworten zu.
- Hohes Risiko: Gesundheitswesen, Finanzen, Recht, sicherheitskritische Unterstützung.
- Domänennuance: Branchenjargon, spezialisiertes Denken.
- Signale der Uneinigkeit: Die automatisierten Bewertungen widersprechen sich oder weichen stark voneinander ab.
Erstellung von Bewertungsrastern und Kalibrierung (einfaches Beispiel)
Beginnen Sie mit einer Skala von 1 bis 5 für Korrektheit , Fundiertheit und Übereinstimmung mit den Richtlinien . Geben Sie pro Bewertung 2–3 kommentierte Beispiele an. Führen Sie kurze Kalibrierungsrunden durch : Die Beurteiler bewerten einen gemeinsamen Stapel von Fällen und vergleichen anschließend ihre Begründungen, um die Konsistenz zu verbessern. Verfolgen Sie die Übereinstimmung zwischen den Beurteilern und lassen Sie Grenzfälle entscheiden.
Methoden: Von LLM als Richter zu echtem HITL
Die Verwendung eines Modells zur Bewertung eines anderen Modells (LLM als Richter) eignet sich gut für die Priorisierung von Fällen : Sie ist schnell, kostengünstig und funktioniert gut bei einfachen Prüfungen. Allerdings kann sie dieselben Schwächen aufweisen – Fehlinterpretationen, Scheinkorrelationen oder „Noteninflation“. Nutzen Sie sie, um Fälle für die menschliche Begutachtung zu priorisieren , nicht um diese zu ersetzen.
Eine praktische Hybrid-Pipeline
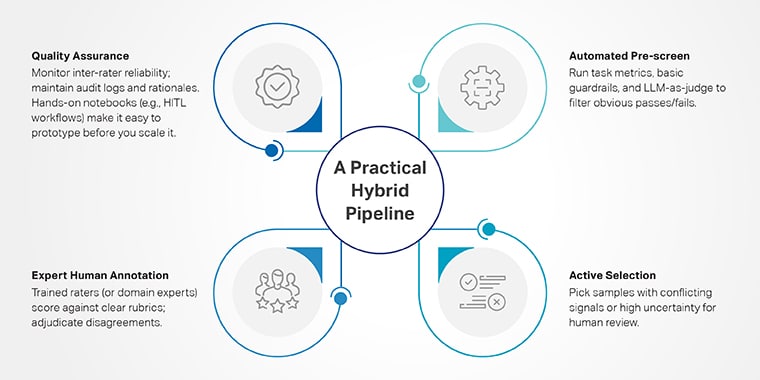
- Automatisierte Vorauswahl: Aufgabenmetriken, grundlegende Leitplanken und LLM als Bewertungskriterium werden ausgeführt, um offensichtliche Erfolge/Fehler herauszufiltern.
- Aktive Auswahl: Proben mit widersprüchlichen Signalen oder hoher Unsicherheit zur manuellen Überprüfung auswählen.
- Menschliche Expertenannotation: Geschulte Gutachter (oder Fachexperten) bewerten anhand klarer Kriterien; Unstimmigkeiten werden beigelegt.
- Qualitätskontrolle: Die Interrater-Reliabilität sollte überwacht und Prüfprotokolle sowie Begründungen geführt werden. Praktische Notizbücher (z. B. HITL-Workflows) erleichtern die Entwicklung von Prototypen für diesen Prozess vor der Skalierung.
Vergleichstabelle: Automatisiert vs. LLM als Richter vs. HITL
Sicherheits- und Risikobenchmarks sind unterschiedlich
Regulierungsbehörden und Normungsinstitutionen erwarten Evaluierungen, die Risiken dokumentieren, realistische Szenarien testen und die Aufsicht nachweisen. Das NIST AI RMF (2024 GenAI Profile) bietet eine gemeinsame Terminologie und gemeinsame Vorgehensweisen; das NIST GenAI Evaluation Program etabliert domänenspezifische Tests; und HELM/AIR-Bench stellt transparente, multimetrische Ergebnisse in den Vordergrund. Nutzen Sie diese als Grundlage für Ihre Governance-Strategie.
Was für Sicherheitsaudits gesammelt werden sollte
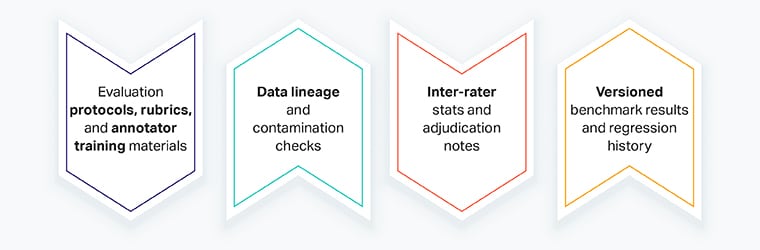
- Evaluierung Protokolle, Rubriken und Annotatorenschulung Materialien
- Datenherkunft und Kontaminationsprüfungen
- Interrater Statistiken und Urteilsvermerke
- Versioniert Benchmark-Ergebnisse und Regressionshistorie
Kurzmeldung: Reduzierung von Fehlalarmen bei der Bank-KYC
Das KYC-Analystenteam einer Bank testete zwei Modelle zur Zusammenfassung von Compliance-Warnmeldungen. Die automatisierten Bewertungen waren identisch. Bei einem Durchlauf mit HITL (High-Intensity-Intelligence-Test) stellten die Prüfer fest, dass Modell A häufig negative Zusätze („keine vorherigen Sanktionen“) wegließ und deren Bedeutung vertauschte. Nach der Überprüfung entschied sich die Bank für Modell B und passte die Eingabeaufforderungen an. Die Anzahl falsch-positiver Ergebnisse sank innerhalb einer Woche um 18 %, wodurch die Analysten mehr Zeit für die eigentlichen Untersuchungen hatten. (Die Lehre daraus: Automatisierte Bewertungen übersahen einen subtilen, aber folgenreichen Fehler; HITL deckte ihn auf.)
Wo Shaip hilft
- Glossar & Bildung: Eine leicht verständliche Erklärung zum Thema „Mensch-in-the-Loop“ und warum dies für GenAI wichtig ist.
- Anleitung & Strategie: A Leitfaden für Anfänger zur LLM-Bewertung für Teams, die ganz von vorne anfangen.
- Plattform: A Plattform zur Bewertung und Überwachung generativer KI um Triage, Experimente und Audits in die Praxis umzusetzen.