Ein erfolgreiches Machine-Learning-Modell beginnt mit qualitativ hochwertigen Trainingsdaten. Doch eine der häufigsten Fragen, die sich Teams zu Beginn eines KI-Projekts stellen, lautet: Wie viele Trainingsdaten sind ausreichend?
Die ehrliche Antwort lautet: Es gibt keine feste Zahl, die für jedes Projekt geeignet ist. Die benötigte Datenmenge hängt von der Aufgabe, der Komplexität des Modells, der Anzahl der Klassen, der Datenqualität, der Genauigkeit der Beschriftungen und dem angestrebten Leistungsstandard ab.
In der Praxis lässt sich der Bedarf an Trainingsdaten am besten abschätzen, indem man mit einer repräsentativen Stichprobe beginnt, das Training schrittweise auf größeren Teilmengen fortsetzt und misst, wann die Modellleistung stagniert. Dies hilft Teams, fundierte Entscheidungen hinsichtlich Kosten, Zeitrahmen, Annotationsaufwand und erwarteten Ergebnissen zu treffen.
In diesem Blogbeitrag erläutern wir die wichtigsten Faktoren, die das Volumen der Trainingsdaten beeinflussen, erklären, wie man den Bedarf in der Praxis abschätzt, und zeigen, was zu tun ist, wenn man mehr Daten benötigt, ohne die KI-Roadmap zu verzögern.
Warum Trainingsdaten wichtig sind
Trainingsdaten bilden die Grundlage jedes Systems für maschinelles Lernen. Egal wie fortschrittlich der Algorithmus ist, er kann nur Muster lernen, die in den Trainingsdaten vorhanden sind. Sind die Daten unvollständig, verzerrt, verrauscht oder zu begrenzt, hat das Modell Schwierigkeiten, in der realen Welt zu generalisieren.
Starke Trainingsdaten helfen Teams:
- Verbesserung der Modellgenauigkeit
- Voreingenommenheit und blinde Flecken reduzieren
- Projektkosten und Machbarkeit genauer einschätzen
- Nacharbeiten während der Modelliteration reduzieren
- zuverlässigere Validierungs- und Testpipelines aufbauen
Deshalb beansprucht die Datenerfassung, -bereinigung, -kennzeichnung und -validierung oft den größten Teil des Aufwands in KI-Projekten. Sind die Daten mangelhaft, sind auch die Vorhersagen ungenau.
Es gibt keine universelle Zahl – aber es gibt einen praktischen Weg, sie zu schätzen.
Viele Artikel versuchen, diese Frage mit einer einzigen Zahl zu beantworten. Das ist selten hilfreich.
Ein Modell für einfache binäre Klassifizierung kann mit einem relativ kleinen Datensatz gute Ergebnisse liefern, während ein umfangreicher Workflow zur Feinabstimmung eines Sprachmodells oder ein Computer-Vision-System für Grenzfälle deutlich mehr Beispiele benötigen kann. Die wichtigere Frage lautet nicht „Was ist die magische Zahl?“, sondern:
Welche Mindestmenge an qualitativ hochwertigen, repräsentativen Trainingsdaten ist erforderlich, um die angestrebte Leistung für diesen Anwendungsfall zu erreichen?
Eine praktische Methode, diese Frage zu beantworten, ist die Verwendung von Lernkurven: Man trainiert das Modell mit zunehmenden Datenmengen und beobachtet, wie sich die Leistung mit jedem Schritt verbessert. Sobald die Verbesserung stagniert, lässt sich deutlicher erkennen, ob sich die Investition in weitere Daten lohnt. Dieser Ansatz wird in praktischen ML-Workflows häufig empfohlen.
7 Faktoren, die bestimmen, wie viele Trainingsdaten Sie benötigen
1. Modelltyp: Klassisches ML vs. Deep Learning
Die Art des Modells hat einen wesentlichen Einfluss auf die Datenanforderungen. Klassische Modelle des maschinellen Lernens wie logistische Regression, Entscheidungsbäume oder Gradient Boosting erzielen oft gute Ergebnisse bei kleineren, strukturierten Datensätzen, insbesondere wenn die Merkmale gut aufbereitet sind.
Deep-Learning-Modelle benötigen im Allgemeinen mehr Daten, da sie Merkmale automatisch lernen und deutlich mehr Parameter enthalten. Bei Bild-, Audio- und Sprachverarbeitungsaufgaben profitieren Deep-Learning-Modelle in der Regel erheblich von einem größeren Datenvolumen und einer höheren Datenvielfalt.
2. Überwachtes vs. unüberwachtes Lernen
Überwachtes Lernen erfordert annotierte Daten, deren Beschaffung oft aufwendiger und kostspieliger ist. Wenn Ihr Modell die Unterstützung von Menschen bei der Bildannotation, Audiotranskription, Entitätskennzeichnung oder Dokumentenklassifizierung benötigt, müssen die Datenanforderungen sowohl die Datenmenge als auch den Aufwand für die Annotation berücksichtigen.
Unüberwachtes Lernen benötigt keine gelabelten Daten, profitiert aber dennoch von großen, repräsentativen Datensätzen. Selbst ohne Labels benötigt das Modell eine ausreichende Abdeckung, um aussagekräftige Muster und Strukturen zu erkennen.
3. Aufgabenkomplexität und Anzahl der Klassen
Eine einfache binäre Klassifizierungsaufgabe unterscheidet sich sehr von einem medizinischen Bildgebungsproblem mit mehreren Klassen oder einem mehrsprachigen Spracherkennungssystem.
Mit zunehmender Aufgabenkomplexität steigen in der Regel auch die Anforderungen an die Trainingsdaten, da das Modell Folgendes lernen muss:
- mehr Kurse
- feinere Unterscheidungen zwischen Kategorien
- weitere Sonderfälle
- mehr kontextuelle Variabilität
Beispielsweise ist es viel einfacher, „Katze“ von „Hund“ zu unterscheiden, als Dutzende von optisch ähnlichen Produktfehlern unter verschiedenen Lichtverhältnissen, Kamerawinkeln und Hintergründen zu identifizieren.
4. Datenqualität und Genauigkeit der Beschriftung
Mehr Daten sind nicht immer besser, wenn die Qualität schlecht ist.
Ein kleinerer Datensatz mit präzisen Labels, ausgewogener Repräsentation und einheitlicher Formatierung kann einem größeren, aber fehlerhaften Datensatz überlegen sein. Minderwertige Labels, doppelte Datensätze, ungenaue Klassendefinitionen, fehlende Metadaten und inkonsistente Annotationsrichtlinien beeinträchtigen die Modellleistung.
Bevor die Teams weitere Daten sammeln, sollten sie sich folgende Fragen stellen:
- Sind die Etiketten einheitlich?
- Decken wir alle wichtigen Nutzerszenarien ab?
- Sind die Daten repräsentativ für die Produktionsbedingungen?
- Sind Trainings-, Validierungs- und Testdatensätze ordnungsgemäß getrennt?
Bei vielen Projekten führt die Verbesserung der Datenqualität zu schnelleren Erfolgen als die bloße Erhöhung des Datenvolumens.
5. Diversität, Abdeckung und Klassenbalance
Ein Modell sollte aus der realen Variabilität lernen, der es nach dem Einsatz begegnen wird. Das bedeutet, dass der Datensatz verschiedene Szenarien, Nutzergruppen, Gerätetypen, Akzente, Umgebungen, Dokumentformate, Bildbedingungen und Grenzfälle widerspiegeln sollte.
Wenn eine Klasse oder ein Segment unterrepräsentiert ist, mag das Modell insgesamt korrekt erscheinen, während es bei kritischen Untergruppen gravierende Mängel aufweist. Deshalb sind Diversität und soziale Ausgewogenheit genauso wichtig wie die reine Größe.
In vielen Fällen lautet die Frage nicht „Haben wir genügend Daten?“, sondern „Haben wir genügend der richtigen Daten?“
6. Transferlernen und vortrainierte Modelle
Wenn Sie mit einem vortrainierten Modell beginnen, benötigen Sie möglicherweise weit weniger aufgabenspezifische Daten als wenn Sie von Grund auf neu trainieren.
Dies gilt insbesondere für:
- Bildklassifizierung mithilfe von Bildverarbeitungs-Backbones
- NLP-Aufgaben unter Verwendung von Transformer-basierten Modellen
- Sprachmodelle, die an einen neuen Akzent oder eine neue Domäne angepasst wurden
- Workflows zur Domänenanpassung
Transferlernen ermöglicht es Teams, Wissen aus großen, bereits vorhandenen Datensätzen wiederzuverwenden, was den Annotationsaufwand erheblich reduzieren kann. Der Originalartikel hat dies bereits gut behandelt; er sollte beibehalten, jedoch mit deutlicheren Beispielen.
7. Validierungsstrategie und Zielvorgaben
Die benötigte Datenmenge hängt auch davon ab, wie gut das Modell sein muss.
Ein Prototyp mag mit geringen Datenmengen funktionieren. Ein Produktionsmodell in Branchen wie dem Gesundheitswesen, dem Finanzwesen, der Versicherungswirtschaft, der Automobilindustrie oder in Umgebungen mit hohem Compliance-Anteil erfordert jedoch eine umfassendere Datenabdeckung, präzisere Kennzeichnungen, eine bessere Validierung und eine zuverlässigere Performance auch in Grenzfällen. Je strenger die zulässige Fehlerrate ist, desto robuster muss Ihr Datensatz sein.
Wie man den Trainingsdatenbedarf in der Praxis abschätzt
Statt zu raten, sollte man einen strukturierten Schätzprozess anwenden.
Schritt 1: Beginnen Sie mit einem repräsentativen Pilotdatensatz
Sammeln Sie eine kleinere, aber repräsentative Stichprobe des Problembereichs. Berücksichtigen Sie wichtige Klassen, Formate, Benutzertypen und reale Variationen.
Schritt 2: Daten richtig aufteilen
Erstellen Sie separate Trainings-, Validierungs- und Testdatensätze. Stellen Sie sicher, dass der Testdatensatz die Produktionsbedingungen widerspiegelt und niemals während des Trainings verwendet wird.
Schritt 3: Training mit zunehmend größeren Stichproben
Trainieren Sie das Modell mit zunehmenden Teilen des Datensatzes, z. B. 10 %, 20 %, 40 %, 60 %, 80 % und 100 %.
Schritt 4: Lernkurve erstellen
Verfolgen Sie Leistungskennzahlen wie Genauigkeit, F1-Score, Trefferquote, Präzision oder aufgabenspezifische Qualitätsmaße bei zunehmender Datensatzgröße.
Schritt 5: Suche das Plateau
Verbessert sich die Modellleistung mit zunehmender Datenmenge deutlich, benötigen Sie wahrscheinlich mehr Daten. Flacht die Verbesserung ab, ist der Flaschenhals möglicherweise nicht mehr das Datenvolumen, sondern die Labelqualität, das Feature-Design, die Modellwahl oder ein Klassenungleichgewicht.
Schritt 6: Segmentleistung überprüfen
Prüfen Sie die Leistung des Modells nicht nur insgesamt, sondern auch in Bezug auf wichtige Klassen und Grenzfälle. Ein Modell kann insgesamt stagnieren, während es bei Minderheitensegmenten weiterhin deutlich schlechter abschneidet. Diese Methode ermöglicht den Beteiligten eine realistischere Einschätzung, wie viele zusätzliche Daten erhoben werden sollten.
Wie man erkennt, wann man über genügend Trainingsdaten verfügt
Sie verfügen wahrscheinlich über genügend Daten, wenn:
- Die Modellleistung verbessert sich durch das Hinzufügen weiterer Daten nur geringfügig.
- Die Validierungsergebnisse sind über mehrere Durchläufe oder Faltungen hinweg stabil.
- Wichtige Klassen erbringen akzeptable Leistungen, nicht nur die Mehrheitsklasse.
- Die Leistung bleibt auch auf einem sauberen, unberührten Testset erhalten.
- Die verbleibenden Fehler werden eher durch Beschriftungsrauschen oder Mehrdeutigkeiten als durch fehlende Beispiele verursacht.
Sie benötigen wahrscheinlich mehr Daten, wenn:
- Die Lernkurve steigt noch an
- Seltene Klassen schneiden schlecht ab
- Das Modell versagt bei gängigen Variationen in der realen Welt.
- Die Ergebnisse schwanken zwischen den Durchläufen stark.
- Die Testleistung sinkt im Vergleich zur Validierungsleistung deutlich.
Wie man den Trainingsdatenbedarf reduziert
Manchmal liegt die Herausforderung nicht im Modelldesign, sondern in Datenknappheit, Budget oder Markteinführungszeit. In solchen Fällen können Teams ihre Abhängigkeit von großen Datenmengen mit den richtigen Strategien reduzieren.
Datenerweiterung
Datenaugmentation erzeugt neue Trainingsbeispiele aus vorhandenen Daten. In der Computer Vision kann dies das Zuschneiden, Drehen, Spiegeln oder Anpassen der Helligkeit umfassen. In der NLP und Sprachverarbeitung muss die Augmentation sorgfältiger erfolgen, aber kontrollierte Transformationen können dennoch hilfreich sein.
Korrekt eingesetzt, verbessert die Datenaugmentation die Robustheit und trägt zu einer besseren Generalisierungsfähigkeit der Modelle bei. Falsch eingesetzt, kann sie Rauschen oder unrealistische Beispiele einführen.
Lernen übertragen
Transferlernen ermöglicht es, ein bestehendes Modell für eine neue Aufgabe anzupassen, anstatt es von Grund auf neu zu trainieren. Dies ist oft eine der effektivsten Methoden, um den Bedarf an Trainingsdaten zu reduzieren.
Vortrainierte Modelle
Vortrainierte Modelle wie BERT-ähnliche NLP-Modelle oder etablierte Bildverarbeitungssysteme bieten eine gute Ausgangsbasis. Anstatt alles von Grund auf neu zu lernen, greift das Modell auf nützliches Vorwissen zurück.
Aktives Lernen
Wenn die Datenkennzeichnung aufwändig ist, kann aktives Lernen dabei helfen, die informativsten Beispiele zu priorisieren. Dies verbessert die Effizienz der Annotation und kann die Anzahl der benötigten Datenkennzeichnungen reduzieren, um eine sinnvolle Leistung zu erzielen.
Synthetische Daten
Synthetische Daten können nützlich sein, wenn reale Daten knapp, sensibel oder schwer zu erheben sind, insbesondere in Bereichen wie dem Gesundheitswesen, dem Finanzwesen, autonomen Systemen und der Simulation von Grenzfällen. Sie sollten jedoch reale, repräsentative Daten ergänzen – und nicht blind ersetzen.
Beispiele aus der Praxis für Machine-Learning-Projekte mit minimalen Datensätzen
Es mag unmöglich klingen, dass einige ehrgeizige Machine-Learning-Projekte mit minimalen Rohstoffen durchgeführt werden können, aber in manchen Fällen ist es erstaunlich wahr. Lassen Sie sich überraschen.
| Kaggle-Bericht | Gesundheitswesen | Klinische Onkologie |
| Eine Kaggle-Umfrage zeigt, dass über 70 % der Projekte zum maschinellen Lernen mit weniger als 10,000 Beispielen abgeschlossen wurden. | Mit nur 500 Bildern trainierte ein MIT-Team ein Modell, um diabetische Neuropathie in medizinischen Bildern aus Augenscans zu erkennen. | Um das Beispiel aus dem Gesundheitswesen fortzusetzen: Einem Team der Stanford University gelang es, mit nur 1000 Bildern ein Modell zur Erkennung von Hautkrebs zu entwickeln. |
Gebildete Vermutungen anstellen
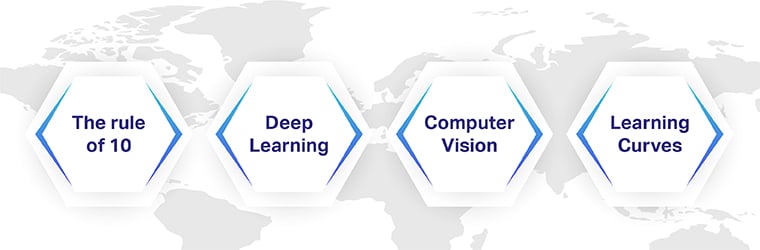
Es gibt keine magische Zahl bezüglich der erforderlichen Mindestdatenmenge, aber es gibt ein paar Faustregeln, die Sie verwenden können, um zu einer rationalen Zahl zu gelangen.
Die Regel von 10
Als Faustregel gilt : Um ein effizientes KI-Modell zu entwickeln, sollte die Anzahl der benötigten Trainingsdatensätze zehnmal so hoch sein wie die Anzahl der einzelnen Modellparameter (Freiheitsgrade). Diese Zehnerregel dient dazu, die Variabilität zu begrenzen und die Datenvielfalt zu erhöhen. Sie kann Ihnen somit als Orientierungshilfe für den Projektstart dienen und Ihnen eine grundlegende Vorstellung von der benötigten Datensatzmenge vermitteln.
Tiefes Lernen
Deep-Learning-Methoden helfen bei der Entwicklung hochwertiger Modelle, wenn dem System mehr Daten zur Verfügung gestellt werden. Es ist allgemein anerkannt, dass 5000 beschriftete Bilder pro Kategorie ausreichen sollten, um einen Deep-Learning-Algorithmus zu erstellen, der mit Menschen auf Augenhöhe arbeiten kann. Um außergewöhnlich komplexe Modelle zu entwickeln, sind mindestens 10 Millionen gekennzeichnete Artikel erforderlich.
Computer Vision
Wenn Sie Deep Learning für die Bildklassifizierung verwenden, besteht Einigkeit darüber, dass ein Datensatz von 1000 gekennzeichneten Bildern für jede Klasse eine angemessene Zahl ist.
Lernkurven
Lernkurven werden verwendet, um die Leistung des maschinellen Lernalgorithmus gegenüber der Datenmenge zu demonstrieren. Indem die Modellkompetenz auf der Y-Achse und der Trainingsdatensatz auf der X-Achse angezeigt wird, ist es möglich zu verstehen, wie sich die Größe der Daten auf das Ergebnis des Projekts auswirkt.
Die Kosten zu geringer Datenmenge
Wenn Teams mit begrenzten, eng gefassten oder verzerrten Datensätzen trainieren, mag das Modell in der Entwicklung vielversprechend erscheinen, versagt aber in der Produktion.
Zu wenige Daten können zu Folgendem führen:
- Überanpassung
- schwache Verallgemeinerung
- instabile Vorhersagen
- schlechte Leistungen in Minderheitenklassen
- höheres Verzerrungsrisiko
- später mehr Iterationszeit
Anders ausgedrückt: Die Einschränkungen Ihrer Trainingsdaten werden oft zu den Einschränkungen Ihres Produkts.
Was zu tun ist, wenn Sie mehr Datensätze benötigen
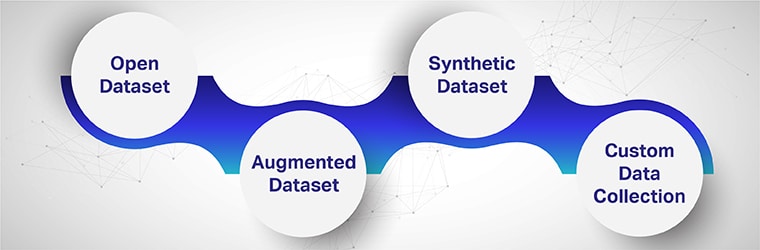
Wenn man eine Datenlücke feststellt, ist die Lösung nicht immer „alles sammeln“. Der intelligentere Ansatz besteht darin, den Datensatz strategisch zu erweitern.
1. Offene Datensätze mit Bedacht verwenden
Offene Datensätze eignen sich zwar für Prototyping oder Benchmarking, sind aber nicht immer für den Produktiveinsatz geeignet. Teams sollten Herkunft, Einwilligung, Qualität, Relevanz und Abdeckung prüfen, bevor sie diese verwenden.
2. Sammeln Sie benutzerdefinierte Daten für Ihren Anwendungsfall
Bei sehr spezifischen Zielumgebungen ist die kundenspezifische Datenerfassung oft die beste Option. Dies gilt insbesondere für domänenintensive Arbeitsabläufe wie KI im Gesundheitswesen, dialogorientierte KI, spezielle Anwendungsfälle der Computer Vision und mehrsprachige Systeme.
3. Vorhandene Daten durch Annotation verbessern
Viele Teams verfügen bereits über Rohdaten, denen es jedoch an Struktur mangelt. Annotation, Neubenennung, Bereinigung der Taxonomie und Qualitätsprüfung können schneller Mehrwert schaffen als die Erfassung völlig neuer Datensätze.
4. Ausgleich der unterrepräsentierten Gruppen
Wenn die Leistung in bestimmten Kategorien schwach ist, sollte man sich bei der Datenerfassung und -kennzeichnung auf diese kritischen Lücken konzentrieren, anstatt den gesamten Datensatz gleichmäßig zu erweitern.
5. Fügen Sie gegebenenfalls synthetische oder angereicherte Daten hinzu.
Wenn reale Daten begrenzt oder sensibel sind, können synthetische und erweiterte Daten zur Verbesserung der Abdeckung beitragen – sie sollten jedoch sorgfältig anhand realer Datenverteilungen validiert werden.
6. Zusammenarbeit mit einem spezialisierten Datenpartner
Für Teams, die KI-Produktionssysteme in großem Umfang entwickeln, kann die Partnerschaft mit einem Anbieter, der hochwertige Trainingsdaten sammeln, lizenzieren, annotieren, validieren und verwalten kann, das Projektrisiko erheblich reduzieren und die Bereitstellung beschleunigen.
Fazit
Es gibt keine magische Zahl für Trainingsdaten im maschinellen Lernen. Die richtige Menge hängt vom Anwendungsfall, dem Modelltyp, der Datenqualität, der Klassendiversität, der Validierungsstrategie und der angestrebten Leistung ab.
Die effektivste Methode zur Abschätzung des Trainingsdatenbedarfs besteht darin, mit einer repräsentativen Stichprobe zu beginnen, die Leistung anhand von Lernkurven zu messen und den Datensatz strategisch zu erweitern, je nachdem, wo das Modell noch versagt.
Für manche Projekte mag ein kleiner, aber qualitativ hochwertiger Datensatz genügen. Bei anderen, insbesondere in Umgebungen mit hohem Einsatz oder starken Schwankungen, hängt der Erfolg von großen, sorgfältig zusammengestellten und gut annotierten Datensätzen ab.
Entscheidend ist nicht einfach nur mehr Daten zu haben, sondern die richtigen Daten zu haben.
Haben Sie ein spannendes Projekt im Sinn, warten aber auf maßgeschneiderte Datensätze zum Trainieren Ihrer Modelle oder erzielen Sie mit Ihrem Projekt nicht die gewünschten Ergebnisse? Wir bieten umfangreiche Trainingsdatensätze für unterschiedlichste Projektanforderungen. Nutzen Sie das Potenzial von Shaip und sprechen Sie noch heute mit einem unserer Data Scientists . Erfahren Sie, wie wir in der Vergangenheit bereits leistungsstarke und qualitativ hochwertige Datensätze für unsere Kunden erstellt haben.